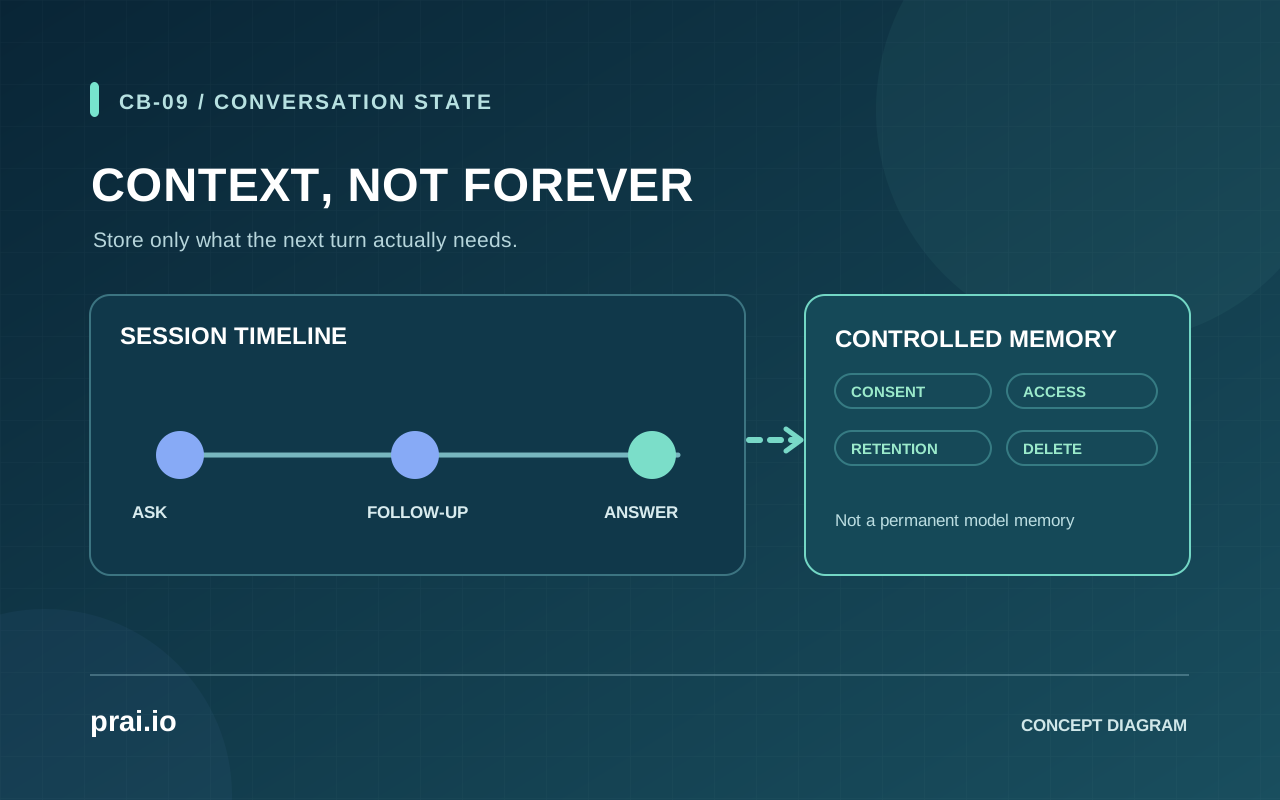
Conversation Memory ในระบบ Chatbot หมายถึงการออกแบบให้การสนทนาครั้งต่อไปใช้ข้อมูลที่เกี่ยวข้องจากครั้งก่อนอย่างเหมาะสม เช่น เข้าใจคำว่า “รุ่นนี้” ว่าหมายถึงสินค้าที่เพิ่งคุยกัน แต่ความสามารถดังกล่าว ไม่ได้เกิดขึ้นอัตโนมัติทุกระบบ และไม่ควรตีความว่าโมเดลจดจำข้อมูลส่วนตัวของผู้ใช้ได้ตลอดไป
สำหรับนักพัฒนา การจัดการ Memory เป็นการตัดสินใจเรื่อง ข้อมูลที่จะเก็บ ระยะเวลาที่ใช้ สิทธิ์ในการอ่าน และการลบ ไม่ใช่เพียงตั้งค่าเปิดปุ่ม “จำบทสนทนา” ให้โมเดล
หากต้องการเข้าใจพื้นฐาน Context และ LLM ก่อน อ่าน AI Chatbot คืออะไร ส่วนการแยก Session Store, Auth และ Logs ในระบบอยู่ที่ Chatbot Architecture
Conversation Context ต่างจาก Long-term Memory อย่างไร
Context คือข้อความหรือข้อมูลที่ส่งให้โมเดลในคำขอหนึ่ง ๆ เช่น ผู้ใช้ถาม “มีรองเท้ารุ่นนี้สีดำไหม” หลังจากพูดถึงรุ่น A ในข้อความก่อน ระบบที่ส่งบริบทส่วนก่อนมาให้โมเดลสามารถตีความคำว่า “รุ่นนี้” ได้ง่ายกว่า
Long-term Memory คือข้อมูลที่เลือกเก็บให้นำกลับมาใช้อีกครั้งในภายหลัง เช่น ภาษาที่ผู้ใช้ต้องการหรือการตั้งค่าบางอย่างซึ่งผู้ใช้ยินยอมไว้ โดยทั่วไปมีฐานข้อมูล/บริการจัดเก็บช่วย ไม่ใช่ข้อมูลที่โมเดลจำติดตัวเองทุกครั้ง
| ระดับข้อมูล | ตัวอย่าง | อายุการใช้งานเชิงออกแบบ | ข้อควรระวัง |
|---|---|---|---|
| Request Context | คำถามล่าสุดและเอกสารที่ค้น | คำขอหนึ่งครั้ง | ข้อมูลเกิน Context Window |
| Session History | ช่วงแชตเดียวกันของผู้ใช้ | ตาม Session ที่กำหนด | Session ID รั่วหรือสลับคน |
| Conversation Summary | สรุปหัวข้อที่คุยค้าง | ช่วงที่จำเป็นต่อการตอบ | สรุปผิดแล้วส่งต่อความผิดพลาด |
| Persisted Preference | ภาษา/ช่องทางติดต่อที่เลือก | ตามนโยบายที่แจ้งและการอนุญาต | ผู้ใช้ต้องแก้ไขและลบได้ตามสิทธิ์ |
ตารางเป็นทางเลือกสำหรับออกแบบ ไม่ได้บอกว่าระบบจริงทุกชนิดต้องเก็บทั้งสี่ชั้น
ทำไมการส่งทุกข้อความเดิมให้ LLM ไม่ใช่คำตอบที่ดีเสมอ
บทสนทนายาวขึ้นทำให้มีข้อมูลมากขึ้น โมเดลมีขอบเขต Context Window และการประมวลผลข้อความเก่าอาจเพิ่มค่าใช้จ่าย นอกจากนี้การเก็บข้อความที่ไม่จำเป็นยังขยายผลกระทบหากข้อมูลรั่ว
ในกรณีที่ต้องสนทนาต่อเนื่อง นักพัฒนาอาจเลือกส่งเฉพาะข้อความล่าสุดที่เกี่ยวข้อง สรุปส่วนที่จบแล้ว หรือเก็บสถานะงานแบบมีโครงสร้าง เช่น current_product_id และ pending_question แทนการนำทุกข้อความกลับเข้า Prompt
เอกสาร OpenAI Conversation state อธิบายวิธีจัดการสถานะโดยส่งประวัติเอง ใช้การเชื่อม Response หรือใช้ Conversations API ข้อกำหนดการจัดเก็บและการลบขึ้นกับบริการ/API ที่เลือก ต้องอ่านนโยบายล่าสุดก่อนใช้งานจริง
เลือก Session ID และ User ID อย่างไร
Session ID ใช้เชื่อมคำขอที่อยู่ในช่วงสนทนาเดียวกัน ส่วน User ID เป็นตัวระบุผู้ใช้ที่ผ่านระบบยืนยันตัวตนตามบริบท ไม่ควรคิดว่า Session ID ที่ Browser ส่งมาเท่ากับหลักฐานว่าผู้ใช้นั้นเป็นเจ้าของข้อมูลโดยอัตโนมัติ
ตัวอย่างจำลอง: ผู้ใช้ A และ B เปิด Chat Widget บนเว็บเดียวกัน หาก Backend ผูกประวัติเฉพาะกับ Cookie ที่ถูกคัดลอกหรือ Session ID ที่เดาได้ อาจทำให้ A เห็นคำถามที่ B พิมพ์ แอปจึงต้องสร้าง ID ที่ไม่คาดเดาง่าย กำหนดอายุ Session และตรวจเจ้าของ Session ทุกครั้งที่อ่าน
สำหรับข้อมูลข้ามอุปกรณ์ ต้องมีวิธีเชื่อมกับบัญชีที่ยืนยันตัวตน ไม่ใช้เพียงชื่อที่ผู้ใช้พิมพ์ในช่องแชต และควรแยกข้อมูลของแต่ละ Tenant/บริษัทตั้งแต่ฐานข้อมูล ไม่หวังให้โมเดลลบข้อมูลของคนอื่นจาก Context
สรุป Memory ได้อย่างไรโดยไม่ยกระดับข้อผิดพลาด
การสรุปบทสนทนาช่วยลดขนาด Context แต่โมเดลอาจเข้าใจผิดได้ เช่น สรุปว่า “ลูกค้ายืนยันรับสินค้าแล้ว” ทั้งที่ผู้ใช้เพียงถามว่าถ้าเปลี่ยนใจทำอย่างไร ความผิดพลาดนั้นอาจถูกส่งต่อซ้ำทุกครั้ง
จึงควรแยก Facts ที่ตรวจจากระบบจริง ออกจาก Preferences ที่ผู้ใช้บอก, Assumptions ที่ยังไม่ได้ยืนยัน และ Next Action ที่รออนุมัติ โดยตั้งกฎว่า Summary ที่โมเดลสร้างไม่ใช่หลักฐานสำหรับเรียก API เปลี่ยนข้อมูล
ตัวอย่างสถานะจำลองที่ปลอดภัยกว่า:
session_ref: [opaque identifier]
current_topic: "ขอข้อมูลค่าจัดส่ง"
product_id: "SKU-DEMO-A"       # จากระบบสินค้า ไม่ใช่เดาจาก LLM
customer_verified: false
pending_question: "ต้องการส่งไปจังหวัดใด?"
consent_to_store_preferences: false
ตัวอย่างนี้ไม่ใช่โค้ดเชื่อมระบบจริง ไม่มีข้อมูลส่วนตัวจริง และไม่ใช่รูปแบบบังคับของแพลตฟอร์มใด
ควรจำข้อมูลอะไร และไม่ควรจำอะไร
เริ่มจากถามว่า ข้อมูลนี้ช่วยให้ผู้ใช้ทำงานสำเร็จจริงหรือไม่ หากไม่จำเป็นก็ไม่ควรเก็บ ข้อมูลที่มีความเสี่ยงสูง เช่น รหัสผ่าน Token เลขบัตร ข้อมูลการเงินหรือข้อความลับ ไม่ควรส่งเข้า Memory หรือ Logs แบบทั่วไป
ข้อมูล Preference ที่ผู้ใช้ยินยอมให้นำไปใช้ เช่น ต้องการคำตอบเป็นภาษาไทย อาจเก็บในบัญชีและให้แก้ไขได้ แต่คำขอให้จดจำข้อมูลที่ละเอียดอ่อนควรตรวจเหตุผล สิทธิ์ และระยะเวลาอย่างรอบคอบ
ข้อความจากเอกสารที่ค้นได้อาจมีคำสั่งแฝงเพื่อให้ Chatbot “จำสิ่งนี้ต่อไป” ดังนั้นข้อมูลจาก Retrieval หรือ Tool Result ต้องเป็น Data ไม่ใช่อำนาจสั่งให้เขียน Memory โดยอัตโนมัติ ดู Chatbot Security สำหรับ Trust Boundary นี้
Retention, Consent และการลบข้อมูล
ก่อนเปิดใช้จริงให้ทำ Data Inventory ว่ามีข้อความใดเข้า Provider, Cache, Database, Logs และระบบ Analytics บ้าง เพราะคำสั่งลบในฐานข้อมูลหลักอย่างเดียวอาจไม่ครอบคลุมสำเนาทั้งหมด
แนวทางออกแบบ:
- แจ้งวัตถุประสงค์และช่วงเวลาจัดเก็บให้ตรงระบบจริง ไม่อ้างว่าไม่เก็บข้อความเมื่อ Provider หรือ Logs ยังเก็บอยู่
- แยกข้อมูลชั่วคราวเพื่อสนทนาต่อจากข้อมูล Preference ที่ต้องเก็บข้าม Session
- ให้ผู้ใช้ตรวจ แก้ไข หรือขอลบข้อมูลที่เกี่ยวข้องตามนโยบายและข้อกำหนดที่ใช้บังคับ
- วางกระบวนการลบที่ครอบคลุม Cache, Export, Backups และผู้ประมวลผลข้อมูลตามความเหมาะสม
- กำหนดสิทธิ์เจ้าหน้าที่และ Audit Log สำหรับการเข้าถึงประวัติ เพื่อไม่สร้างปัญหา Privacy ใหม่
หากองค์กรต้องการใช้ข้อมูลย้อนหลังเพื่อปรับโมเดลหรือ Analytics ต้องประเมินวัตถุประสงค์และฐานทางกฎหมายแยก ไม่ถือว่าการใช้ Chatbot เท่ากับยินยอมให้ใช้ข้อมูลทุกอย่าง
ทดสอบ Memory ด้วยกรณีที่พบบ่อย
เริ่มทดสอบ “แล้วรุ่นนี้ล่ะ” ใน Session ที่มีการพูดถึงรุ่น A และ Session ใหม่ที่ไม่เคยมีข้อมูล ถ้าเป็น Session ใหม่ Bot ควรถามว่าหมายถึงรุ่นไหน ไม่อ้างว่าจำได้จากผู้ใช้อื่น
ทดสอบอีกว่าเมื่อผู้ใช้แก้ข้อมูลเดิม ระบบอัปเดตสถานะไม่สรุปซ้ำผิด ๆ อย่างไร เมื่อผู้ใช้ขอลบ Memory มีอะไรถูกลบจริงบ้าง และเมื่อ Session หมดอายุมีวิธีไม่ส่งประวัติเดิมไปให้คนผิดอย่างไร
ตัวชี้วัดที่มีประโยชน์คือจำนวนครั้งที่ Bot ต้องถามซ้ำโดยไม่จำเป็น จำนวนครั้งที่ใช้บริบทผิด และเหตุการณ์ข้อมูลข้ามผู้ใช้ ไม่จำเป็นต้องสมมติเปอร์เซ็นต์ความแม่นยำก่อนมีข้อมูล
คำถามที่พบบ่อย
โมเดล AI จำบทสนทนาทุกครั้งโดยอัตโนมัติไหม
ไม่เสมอไป ต้องดูว่าระบบส่งประวัติในคำขอหรือใช้บริการจัดการ State อย่างไร และมีนโยบายจัดเก็บข้อมูลอะไร
ใช้ Vector Database เก็บ Memory ได้ไหม
ใช้เป็นส่วนค้นความหมายจากข้อมูลที่มีสิทธิ์เก็บได้ แต่ไม่ทดแทนฐานข้อมูลสถานะที่ต้องถูกต้อง การจัดสิทธิ์และการลบ ต้องออกแบบให้ครบ
ต้องเก็บข้อมูลลูกค้าตลอดไปเพื่อให้ Chatbot เก่งขึ้นหรือไม่
ไม่ ควรเก็บเฉพาะข้อมูลที่มีวัตถุประสงค์และระยะเวลาที่สมเหตุสมผล รวมถึงมีวิธีแก้ไข/ลบตามข้อกำหนดที่เกี่ยวข้อง
แหล่งอ้างอิง
- OpenAI Developers — Conversation state
- OpenAI Developers — Migrate to Responses API
- OWASP GenAI — LLM Top 10 2026
ตรวจเอกสารต้นทาง: 2 พฤศจิกายน 2026; ตัวอย่างและแนวทางการเก็บข้อมูลเป็นกรอบออกแบบ ต้องตรวจนโยบายผู้ให้บริการและกฎหมายที่เกี่ยวข้องในระบบจริง
เลือกหัวข้อที่เกี่ยวข้องเพื่อทำความเข้าใจแนวคิดและข้อจำกัดก่อนนำไปใช้จริง
ดูบทความหมวดเทคโนโลยี ↗