Chatbot Architecture คือการออกแบบว่าส่วนรับข้อความ ส่วนตรวจสิทธิ์ ส่วนประมวลผลคำถาม โมเดล AI แหล่งข้อมูล และระบบปฏิบัติการทำงานร่วมกันอย่างไร สำหรับระบบที่ใช้งานจริง คำถามสำคัญไม่ใช่เพียงเลือก LLM รุ่นใด แต่คือ ใครเป็นเจ้าของข้อมูล ใครอนุญาตให้เรียก API และจะเกิดอะไรเมื่อส่วนหนึ่งของระบบล้มเหลว
การออกแบบที่ดีช่วยให้เปลี่ยนโมเดลหรือช่องทางแชตได้โดยไม่ต้องรื้อระบบธุรกิจทั้งหมด และลดความเสี่ยงจากการให้ AI ติดต่อฐานข้อมูลโดยตรงโดยไม่มีชั้นตรวจสิทธิ์
บทความนี้เน้นภาพรวม System Design หากต้องสร้างกล่องแชตบนเว็บ เริ่มจาก สร้าง Chatbot บนเว็บไซต์ ถ้าต้องใช้ข้อมูลภายในบริษัท อ่าน RAG Chatbot เพิ่มเติม
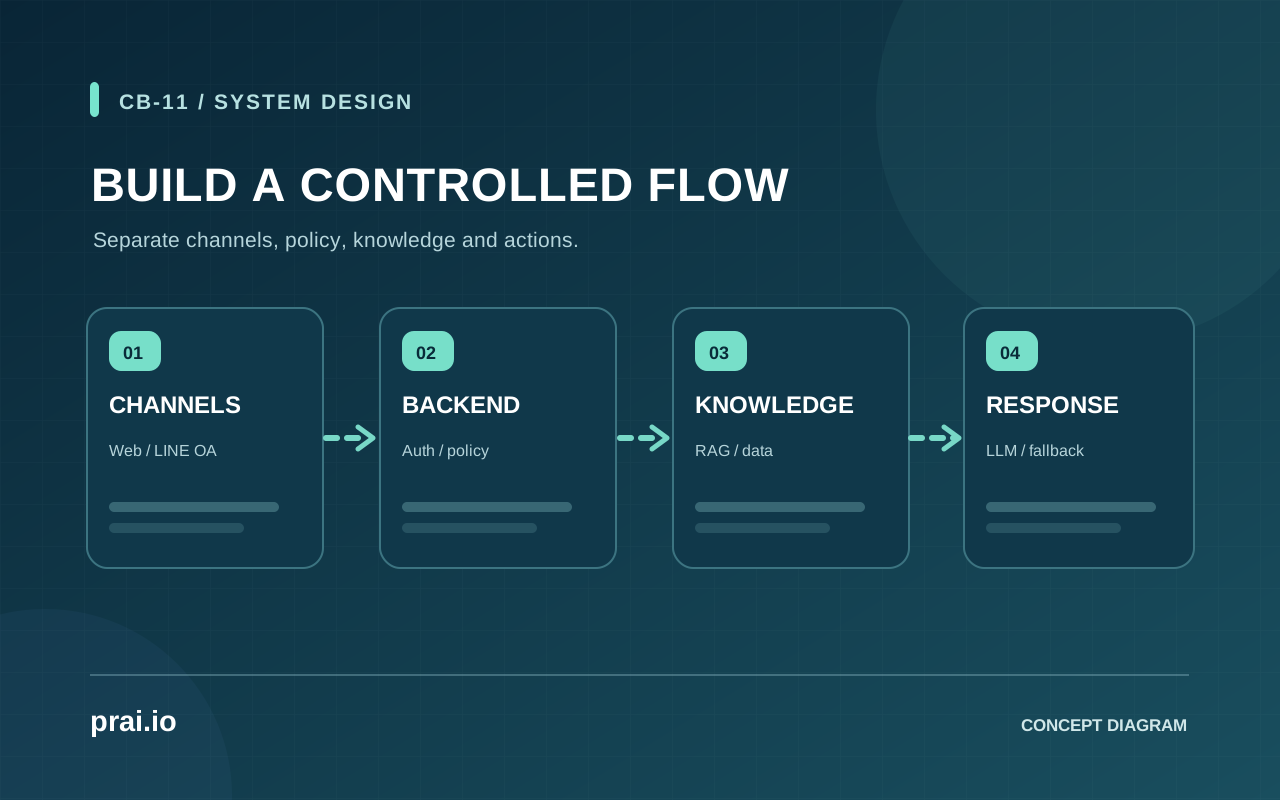
ส่วนประกอบหลักของระบบ Chatbot
สถาปัตยกรรมแบบพื้นฐานที่รองรับหลายช่องทางอาจแบ่งชั้นดังนี้
| ชั้นระบบ | หน้าที่ | สิ่งที่ต้องควบคุม |
|---|---|---|
| Chat UI / Channel Adapter | รับข้อความจากเว็บหรือ Messaging Platform | UX, การเข้าถึง, การตรวจ Webhook |
| API Gateway / Backend | ตรวจตัวตน Rate Limit และจัด Session | Authentication, Authorization, Validation |
| Conversation Orchestrator | เลือก Flow, Retrieval หรือ Tool ที่ต้องใช้ | Policy, Fallback, Human Handoff |
| LLM Provider | ช่วยตีความหรือสร้างข้อความตอบ | Model Config, Token Budget, Failures |
| Knowledge/Retrieval | ค้น FAQ และเอกสารตามสิทธิ์ | Index, Versions, Tenant Isolation |
| Business API / Database | อ่านหรือแก้ข้อมูลตามสิทธิ์ | Transactions, Audits, Idempotency |
| Observability | ติดตามเหตุการณ์และความผิดพลาด | PII Redaction, Trace/Cost/Latency |
การแยกชั้นเป็นแนวคิด ไม่ใช่ Microservices ทุกกรณี แอปขนาดเล็กอาจรวมหลายส่วนใน Backend เดียวและยังคงมีขอบเขตสิทธิ์ที่ชัดเจนได้
Chat UI กับ Channel Adapter อยู่ตรงไหน
Frontend มีหน้าที่รับคำถาม แสดงสถานะกำลังตอบ และให้ผู้ใช้กลับไปติดต่อคนได้ ไม่ควรเก็บ API Secret หรือส่งข้อมูลบริษัททั้งหมดลง JavaScript ของ Browser
ถ้ารองรับ LINE OA จะมี Webhook Adapter รับ Event และตรวจ x-line-signature จาก Raw Request Body ก่อนยอมรับข้อมูล ตาม LINE Developers — Receiving messages ข้อแตกต่างคือช่องทางส่งข้อความและวิธีรับ Event แต่ทั้ง Web และ LINE สามารถส่งเข้ากระบวนการ Orchestrator ที่ใช้ร่วมกันได้เมื่อระบบออกแบบไว้
ต้องระวังไม่ใช้เพียง LINE User ID หรือ Session ID เป็นหลักฐานว่าเข้าถึงข้อมูลลูกค้าภายในระบบอื่นได้ ต้องมีการผูกบัญชีและตรวจสิทธิ์ที่เหมาะสม
Backend ควรดูแลอะไรบ้างก่อนเรียก LLM
Backend เป็นจุดที่รวมกฎจริง เช่น ตรวจรูปแบบข้อความและขนาดคำขอ จำกัด Rate ตามผู้ใช้/ช่องทาง ตรวจตัวตน แล้วตัดสินว่าจะตอบจาก FAQ หรือจำเป็นต้องเรียกโมเดล
ตัวอย่างทางเดินข้อมูลเชิงแนวคิด:
Web Widget --------+
                    +--> Adapter / API Gateway
LINE Webhook ------+        |
                       AuthN / AuthZ
                            |
                    Conversation Orchestrator
                      /       |          \
                  FAQ/RAG    LLM      Business API
                      \       |          /
                      Response Composer
                            |
                     Reply / Fallback
                            |
                   Metrics + Safe Audit
ภาพนี้ไม่ได้แสดงว่า Prai.io เปิด Chatbot Production หลายช่องทางแล้ว และไม่ได้เป็นแบบระบบที่จะเหมาะกับทุกองค์กร ต้องปรับตามข้อมูล/สิทธิ์และ Hosting จริง
ข้อห้ามเชิงออกแบบ: ไม่ให้โมเดลอ่านตารางลูกค้าทั้งหมดก่อนค่อยบอกให้ “เลือกเฉพาะของคนนี้” การกรองและตรวจสิทธิ์ต้องทำที่ Backend และ Data Access Layer ก่อนให้ข้อมูลเข้าสู่ Context
เลือกใช้ FAQ, RAG หรือ Business API อย่างไร
งานตอบวิธีติดต่อและข้อมูลบริการสาธารณะอาจใช้ FAQ โดยไม่ต้องเรียก LLM งานค้นคู่มือจำนวนมากใช้ RAG เพิ่มหลักฐาน และงานตรวจสถานะจริงที่เปลี่ยนทุกวินาทีควรเรียก Business API ภายใต้สิทธิ์ผู้ใช้
กลไก Tool Calling อาจให้ LLM เสนอการเรียกฟังก์ชัน แต่ Backend ยังเป็นผู้ Validate, Authorize และ Execute ส่วน Microsoft Foundry อธิบายวิธีประกอบ Retrieval เข้า Generation เมื่อข้อมูลอยู่ในเอกสาร
การเลือกเส้นทางตอบควรตั้งเงื่อนไข Fallback ที่ชัดเจน เช่น API Order ล่ม → แจ้งไม่สามารถตรวจสถานะได้ตอนนี้ และให้ผู้ใช้ติดต่อตามช่องทางที่ยืนยัน ไม่แต่งสถานะจากคำตอบในอดีต
Session, Database, Vector Search และ Logs ต้องเก็บอะไร
แยกข้อมูลอย่างน้อยสี่ประเภท ได้แก่ ข้อมูลธุรกิจจริง (Orders, Customers), สถานะ Session ที่จำเป็น, Knowledge Index (เอกสารค้นได้) และ Audit/Telemetry (เหตุการณ์ที่ต้องตรวจ)
ข้อมูลเหล่านี้มีอายุการใช้งานและการควบคุมไม่เหมือนกัน บันทึกทุกข้อความไว้ถาวรเพียงเพราะอยากวัดคุณภาพในอนาคตอาจขัดกับหลักการลดข้อมูลที่ไม่จำเป็น ส่วนการเก็บ Session แบบผิดเจ้าของอาจทำให้แชตของคนหนึ่งไปปนกับอีกคน
สำหรับเรื่องนี้โดยเฉพาะ อ่าน Conversation Memory และ Vector Database สำหรับ Chatbot เพื่อแยกโจทย์ State กับ Retrieval ที่ไม่ใช่ฐานข้อมูลเดียวกันเสมอ
รองรับความล้มเหลวโดยไม่เดาผลลัพธ์
ระบบที่ใช้ LLM และ API ภายนอกมีหลายจุดที่อาจช้า/ล่ม/หมดโควตา จึงต้องกำหนด Timeout, Retry, Fallback และผู้รับช่วงต่อให้เหมาะกับแต่ละรายการ
ตัวอย่างเชิงออกแบบ:
- Model Timeout: แจ้งว่าตอบไม่ได้ในขณะนี้ หากเป็น FAQ สาธารณะอาจตอบจากข้อมูลที่ตรวจแล้วได้
- Retrieval ไม่พบข้อมูล: แจ้งไม่พบหลักฐาน ไม่ตีความว่าเรื่องนั้นไม่มีอยู่จริง
- Order API Error: ห้ามบอกว่า “ส่งสินค้าแล้ว” จนกว่าจะมีผลลัพธ์จริง
- Write Action ล้มเหลวหลัง Retry: ตรวจ Idempotency และสถานะธุรกรรมก่อนทำซ้ำ
- Human Handoff ไม่พร้อม: แจ้งเวลาหรือช่องทางตามจริง ไม่สัญญาว่าคนกำลังอ่านหากไม่มีเจ้าหน้าที่รับงาน
การแยกประเภท Error ช่วยให้แก้ปัญหาได้ตรงจุดและลดการส่งข้อความผิดให้ผู้ใช้
คิดต้นทุนและ Performance จากจุดไหน
ต้นทุนไม่ได้มีแต่ Token ของโมเดล แต่รวมการเก็บเอกสาร/Index, คำค้น, Hosting, Monitoring, การจัดการสิทธิ์ และคนดูแลเนื้อหา หากมีการเรียก Retrieval และ LLM หลายครั้งต่อคำถาม ค่าใช้จ่ายและเวลาตอบอาจเพิ่มขึ้น
ควรเก็บตัวชี้วัดในแต่ละชั้น เช่น อัตราคำขอที่ไม่ต้องใช้โมเดล, จำนวน Retrieval Calls, Token Usage, API Errors และเวลาตอบตามเส้นทาง โดยทำ Aggregate ในระดับที่ไม่เปิดเผยข้อมูลส่วนบุคคล
อย่าตั้งตัวเลข Latency/Throughput ให้สถาปัตยกรรมบนกระดาษ หากยังไม่ทดสอบบนโครงสร้างและปริมาณงานจริง วาง Budget/Alert สำหรับค่าใช้จ่ายก่อนเปิด Production ด้วย
Security Boundary และการวาง Secret
เก็บ Key/Token ในระบบจัดการ Secret ฝั่ง Server ตาม Platform ไม่ส่งเข้าหน้าเว็บหรือ Prompt ของโมเดล สร้าง Role และ Permission สำหรับแต่ละ API โดยตั้งค่า Default Deny เมื่อไม่มีสิทธิ์
ในชั้น Retrieval ให้กรองเอกสารตาม Tenant/User Scope ก่อนส่ง Context ส่วน Tool ที่มีผลต่อเงินหรือข้อมูลสำคัญต้องมี Approval และ Audit Trail ตามความเหมาะสม
อ่านต่อ Chatbot Security เพราะการตั้ง Firewall หรือซ่อน Endpoint อย่างเดียวไม่พอเมื่อข้อความจากผู้ใช้และเอกสารภายนอกอาจมี Prompt Injection
แผนเริ่มต้นสำหรับทีมขนาดเล็ก
เริ่มจาก Chat UI หนึ่งช่องทางกับ FAQ ที่เจ้าของข้อมูลยืนยันได้ ออกแบบ Backend ตรวจคำขอและ Fallback ให้ดี ต่อมาเพิ่ม RAG เมื่อมีเอกสารจำนวนมากและชุดคำถามทดสอบพร้อม หากต้องดึงธุรกรรมสดจึงเพิ่ม Business API พร้อม Permission Check
ก่อนขยายเป็นหลาย Channel ควรประเมินว่ามีผู้ดูแลข้อมูล เจ้าหน้าที่รับช่วงต่อ และการติดตาม Error เพียงพอหรือยัง ตัวเลขเชิงธุรกิจต้องวัดจากการใช้จริง ไม่สร้าง Case Study จำลองให้ดูเหมือนผลงานลูกค้า
หากต้องออกแบบเว็บแอปสำหรับโจทย์องค์กรสามารถดูขอบเขตงานที่ Prai.io เปิดให้ปรึกษาที่ Web Apps & Digital Tools โดยไม่ถือว่ารับประกันการรองรับทุก Integration หรือข้อกำหนดเฉพาะ
คำถามที่พบบ่อย
ต้องใช้ Microservices เพื่อทำ Chatbot จริงไหม
ไม่จำเป็น เริ่มจาก Backend เดียวที่แยกหน้าที่และสิทธิ์ชัดเจนอาจเหมาะสมกว่า แล้วปรับเมื่อปริมาณงานจริงจำเป็น
ใช้ Database เดียวเก็บทุกอย่างได้ไหม
บางระบบทำได้ แต่ต้องแยกตาราง สิทธิ์ Retention และการทดสอบความเสี่ยง ไม่ใช่เปิดข้อมูลทั้งหมดให้โมเดล
ถ้า LLM ล่มยังให้ Chatbot ใช้ได้หรือไม่
ขึ้นกับระบบที่ออกแบบไว้ เช่น FAQ หรือเส้นทางติดต่อคนอาจยังใช้ได้ ต้องทดสอบ Fallback จริงก่อนรับประกันต่อผู้ใช้
แหล่งอ้างอิง
- OpenAI Developers — Using tools
- Microsoft Foundry — RAG and indexes
- LINE Developers — Receive messages
- OWASP GenAI — LLM Top 10 2026
ตรวจเอกสาร: 2 พฤศจิกายน 2026; สถาปัตยกรรมนี้เป็นแนวคิด ไม่ใช่แผนผัง Production ของลูกค้าหรือผล Benchmark จริง
เลือกหัวข้อที่เกี่ยวข้องเพื่อทำความเข้าใจแนวคิดและข้อจำกัดก่อนนำไปใช้จริง
ดูบทความหมวดเทคโนโลยี ↗