RAG (Retrieval-Augmented Generation) คือแนวทางให้ระบบ AI ค้นข้อมูลที่เกี่ยวข้องก่อน แล้วนำผลค้นไปประกอบคำขอให้โมเดลสร้างคำตอบ แทนการพึ่งข้อความที่โมเดลเรียนรู้มาเพียงอย่างเดียว สำหรับ Chatbot ขององค์กร RAG ช่วยให้คำตอบยึดเอกสารนโยบาย คู่มือ หรือ FAQ ที่เจ้าของข้อมูลดูแลได้ โดยผู้พัฒนาต้องยังคงตรวจสิทธิ์ ความสดของข้อมูล และความถูกต้องของข้อความที่โมเดลสรุป
ตัวอย่างสมมติ: พนักงานถาม “ปีนี้ลาพักร้อนได้กี่วัน” ถ้าโมเดลไม่ได้รับนโยบายของบริษัท ก็ไม่ควรคาดเดาตัวเลข RAG สามารถค้นฉบับนโยบายที่ผู้ถามมีสิทธิ์อ่านและส่งส่วนที่เกี่ยวข้องให้โมเดลอธิบายได้ ถ้าพบเอกสารขัดกัน คำตอบที่ถูกต้องอาจเป็น “ยังยืนยันไม่ได้ กรุณาติดต่อฝ่ายบุคคล” มากกว่าการเลือกตัวเลขเอง
หน้านี้เน้น กระบวนการ RAG แบบครบเส้นทาง ส่วนรายละเอียดว่า Embedding และ Vector Index ค้นอย่างไรอยู่ใน Vector Database กับ Chatbot หากเพิ่งเริ่มต้นด้วย LLM อ่าน AI Chatbot คืออะไร ก่อน
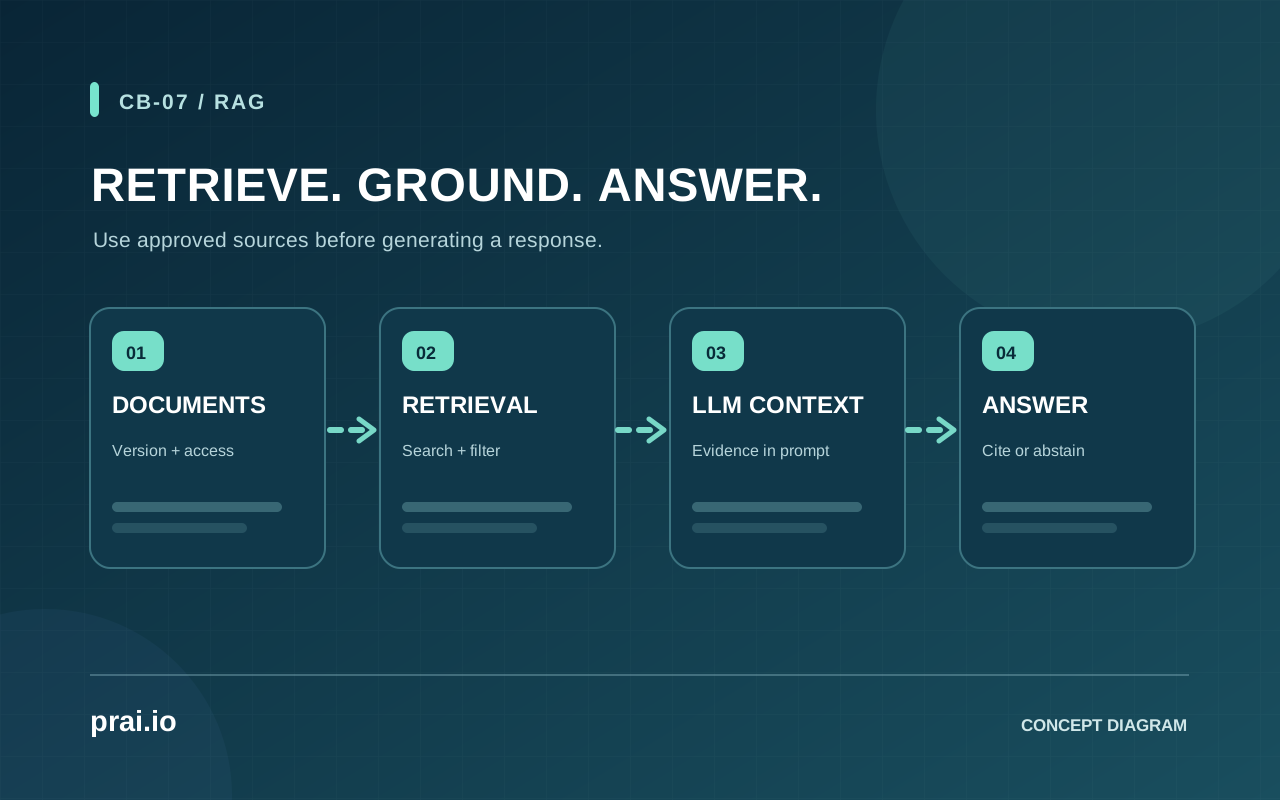
RAG ทำงานอย่างไร: Retrieve → Augment → Generate
กระบวนการมาตรฐานมีสามขั้นตอนใหญ่ตามแนวคิดที่ Microsoft Foundry อธิบายไว้
- Retrieve: แอปแปลงคำถามให้เป็นคำค้น ส่งไปยังระบบค้นข้อมูล และรับเอกสารที่เกี่ยวข้องกลับมา โดยต้องใช้สิทธิ์ของผู้ถามกำหนดขอบเขตผลค้น
- Augment: แอปคัดข้อมูลที่เหมาะสม รวมคำถาม ข้อความต้นฉบับที่เชื่อถือได้ วันของเอกสาร และกติกาการตอบเข้าเป็น Context
- Generate: โมเดลสร้างคำอธิบายจาก Context ที่ได้รับ แอปแสดงลิงก์อ้างอิงจริงและแจ้งข้อจำกัดเมื่อหลักฐานไม่เพียงพอ
จุดที่มักเข้าใจผิดคือ การค้นได้ไม่ได้แปลว่าคำตอบตรงเอกสารเสมอ โมเดลอาจอ่านผิด สรุปเกินข้อความ หรือผูกชื่อเอกสารผิดกับคำตอบ จึงต้องตรวจทั้งสองช่วง: คุณภาพการค้น (retrieval) และความถูกต้องของคำตอบ (answer groundedness)
เอกสารที่ผ่านการอนุมัติ → แยกส่วน + บันทึกแหล่งที่มา + Index
                                      |
คำถาม + สิทธิ์ผู้ใช้ → ค้นเอกสารที่อนุญาต → ส่วนที่เกี่ยวข้อง
                                      |
                           Context + คำสั่งให้ตอบตามหลักฐาน
                                      |
                                     LLM
                                      |
                       คำตอบ + แหล่งอ้างอิง / ไม่พบข้อมูล
ภาพกระบวนการข้างต้นเป็น สถาปัตยกรรมจำลอง ไม่ใช่หลักฐานว่าบริษัทใดเปิดระบบดังกล่าวแล้ว
เตรียมเอกสารก่อนสร้าง Knowledge Base
ก่อนอัปโหลดคู่มือเข้าแพลตฟอร์ม AI ควรสำรวจว่ามีเจ้าของข้อมูลหรือไม่ เอกสารมีหลายฉบับที่ขัดกันหรือเปล่า ใช้ได้กับพนักงานทุกคนหรือเฉพาะบางทีม และมีวันหมดอายุหรือไม่ สิ่งเหล่านี้สำคัญกว่าจำนวนไฟล์
ตัวอย่างข้อมูลกำกับ (Metadata) ของแต่ละส่วนเอกสาร:
| ฟิลด์ | หน้าที่ | ตัวอย่างจำลอง |
|---|---|---|
| Document ID / Version | ช่วยแยกฉบับล่าสุดกับฉบับเก่า | policy-leave-v3 |
| Title / Source URL | ทำลิงก์อ้างอิงให้ผู้อ่านตรวจต่อ | นโยบายการลา ฉบับล่าสุด |
| Owner / Reviewed At | รู้ว่าใครรับรองและตรวจเมื่อใด | HR / วันที่ตรวจในระบบ |
| Access Scope | จำกัดผู้เห็นก่อนคืนผลค้น | staff-hr หรือ public |
| Effective Period | บอกช่วงเวลาใช้นโยบาย | มีผลตั้งแต่วันที่ประกาศ |
การแยกเอกสารยาวเป็นส่วนย่อย (Chunking) ช่วยให้ค้นประเด็นเฉพาะได้ แต่ Chunk ที่สั้นเกินไปอาจตัดข้อยกเว้นออกจากประโยคหลัก ส่วน Chunk ยาวเกินไปอาจเจอข้อความที่ไม่เกี่ยวข้อง วิธีตั้ง Chunk Size ต้องทดสอบกับชนิดเอกสาร ไม่มีกฎตัวเลขเดียวที่เหมาะกับทุกองค์กร
ในระบบจริงควรมีแนวทางอัปเดต Index เมื่อเอกสารถูกแก้ไข และลบเวอร์ชันเก่าออกจากผลค้นที่ใช้งาน ไม่เช่นนั้น Bot อาจตอบข้อมูลที่ถูกต้องตามเอกสารเก่า แต่ผิดตามนโยบายใหม่
ควรค้นแบบ Keyword, Vector หรือ Hybrid
Keyword Search เหมาะกับรหัสสินค้า เลขเอกสาร ชื่อเฉพาะ และคำที่ต้องตรงรูป ส่วน Vector Search ใช้ Embedding เพื่อหาข้อความที่มีความหมายคล้ายกัน แม้คำไม่ตรงตัว และ Hybrid Search ผสมสัญญาณทั้งสองแบบ
สมมติผู้ใช้ถาม “ทำงานจากบ้านลาหยุดอย่างไร” ขณะที่คู่มือเขียนว่า “การลาของพนักงานแบบ Remote Work” การค้นแบบความหมายอาจช่วยได้ แต่หากถามเลขข้อกำหนด “HR-2026-04” การค้นคำตรงตัวมีความสำคัญมากกว่า
อย่าเลือกเทคโนโลยีจากชื่อที่ดูซับซ้อน ระบบ FAQ เพียงสิบข้ออาจใช้การจับข้อความปกติก็พอ การลงทุน Vector Index เพิ่มทั้งค่าใช้จ่าย การดูแล Chunk และการประเมินผล ต้องมีเหตุผลจากชุดคำถามจริง Azure AI Search อธิบายการใช้ Hybrid Search และ Semantic Ranking เป็นทางเลือกหนึ่ง ไม่ใช่เงื่อนไขที่ทุก RAG ต้องใช้
การอ้างอิงที่มาควรทำอย่างไร
คำตอบที่ดีต้องชี้ว่าแต่ละข้อความสำคัญมาจากเอกสารใด โดยเชื่อม Citation กับ Document ID/URL/Section ที่ระบบดึงมาได้จริง ไม่ให้โมเดลประดิษฐ์ชื่อไฟล์หรือหมายเลขหน้าจากความคุ้นเคย
ตัวอย่างสมมติ: ระบบตอบว่า “ตามหัวข้อการลาในนโยบายพนักงานฉบับล่าสุด การลาต้องแจ้งล่วงหน้าตามเงื่อนไขของแผนก” พร้อมลิงก์ที่ผู้ใช้มีสิทธิ์เปิดได้ ถ้าไม่มีเอกสารยืนยันช่วงวันหรือผู้อนุมัติ ให้ระบุว่าไม่มีข้อมูลส่วนนี้ แทนการเติมกฎขึ้นมาเอง
ควรตรวจว่าลิงก์อ้างอิงยังใช้ได้สำหรับ ผู้ถามคนนั้น ด้วย การแสดง URL ไฟล์ภายในบริษัทอาจกลายเป็นช่องทางรั่วข้อมูลหากระบบสร้างลิงก์ที่ข้ามการยืนยันตัวตน
ความปลอดภัยต้องเริ่มตั้งแต่ก่อน Retrieval
การใส่ข้อความใน Prompt ว่า “ห้ามเปิดข้อมูล HR” ไม่เพียงพอ แอปต้องบังคับ Authorization ที่ระบบค้นเอกสาร เช่น จำกัดผลค้นตาม Tenant, Group หรือ User ก่อนให้เนื้อหาเข้าถึงโมเดล และตรวจซ้ำก่อนเปิด URL ต้นฉบับ
เอกสารที่ค้นได้ก็เป็น Untrusted Data ในมุมความปลอดภัย หากเอกสารปะปนข้อความแอบสั่งให้ Bot เปลี่ยนนโยบายหรือเรียก Tool แอปต้องไม่ตีความคำสั่งที่ฝังอยู่ในเอกสารเป็นสิทธิ์ของผู้ใช้ เรียนรู้ขอบเขตนี้ต่อใน Chatbot Security และ Chatbot Architecture
วัดคุณภาพ RAG อย่างไรโดยไม่สร้างตัวเลขลอย ๆ
สร้างชุดคำถามทดสอบจากเอกสารจริงที่ตัดข้อมูลส่วนตัวออก และมีคำตอบอ้างอิงที่เจ้าของเอกสารรับรอง แยกคำถามเป็นกลุ่มดังนี้
- พบคำตอบตรง ๆ: ต้องค้นส่วนที่มีคำตอบและตอบโดยไม่เปลี่ยนเงื่อนไข
- ใช้คำต่างจากเอกสาร: ต้องค้นประเด็นถูกโดยไม่ดึงเอกสารอื่นที่ความหมายใกล้เกินไป
- ไม่พบคำตอบ: ต้องระบุไม่พบและมีทางส่งต่อ ไม่สร้างคำตอบขึ้นเอง
- เอกสารขัดกันหรือหมดอายุ: ต้องจัดการเวอร์ชันหรือแจ้งความไม่แน่นอน
- ผู้ใช้ไม่มีสิทธิ์: ต้องไม่คืนข้อความหรือ Citation ที่เปิดข้อมูลต้องห้าม
วัดสองชุดแยกกัน ได้แก่ Retrieval Hit/Recall จากเอกสารที่ควรเจอ และ Answer Correctness/Groundedness จากข้อความตอบ ไม่ควรสรุปว่า RAG แม่นยำกี่เปอร์เซ็นต์หากยังไม่เคยทดสอบกับข้อมูลจริง
ต้องใช้ RAG ทุกครั้งที่สร้าง AI Chatbot หรือไม่
ไม่จำเป็น หากต้องตอบ FAQ สั้นและควบคุมข้อความได้ตรง ๆ ก็อาจใช้ Rule-based; ถ้าคำตอบต้องการสถานะสดจากระบบ Order ควรดึง API ด้วยสิทธิ์ที่ตรวจแล้ว ไม่ใช่คัดลอกจากเอกสารที่อัปเดตช้า หากงานเป็นคู่มือจำนวนมากและต้องอ้างที่มา RAG จึงเหมาะกว่า
สำหรับผู้เริ่มต้น แนะนำทำ Proof of Concept ด้วยเอกสารสาธารณะขนาดเล็กที่มีเจ้าของและชุดคำถามทดสอบก่อน แล้วค่อยเพิ่ม Retrieval/Access Control ที่จำเป็น ควรอ่าน Vector Database และ Embeddings เมื่อเริ่มต้องแก้ปัญหาคุณภาพการค้น
คำถามที่พบบ่อย
RAG ทำให้ Chatbot ไม่ตอบผิดอีกเลยหรือไม่
ไม่ RAG ช่วยให้โมเดลได้รับหลักฐาน แต่ยังมีความเสี่ยงจากการค้นผิดฉบับ ข้อมูลเก่า สรุปผิด และการอ้างอิงคลาดเคลื่อน
RAG กับการ Fine-tune โมเดลเหมือนกันหรือไม่
ไม่ RAG เตรียม Context จากแหล่งข้อมูลในช่วงตอบ ส่วน Fine-tuning ปรับพฤติกรรมโมเดลผ่านการฝึกเพิ่มเติม ทั้งสองมีวัตถุประสงค์และข้อจำกัดต่างกัน
ควรให้ผู้ใช้เห็นเอกสารอ้างอิงทุกฉบับหรือไม่
ให้เห็นเฉพาะเอกสารที่ผู้ใช้นั้นมีสิทธิ์เข้าถึง และตรวจลิงก์ปลายทางซ้ำ ไม่แสดงชื่อหรือ URL ที่เปิดเผยข้อมูลเกินสิทธิ์
แหล่งอ้างอิง
- Microsoft Foundry — Retrieval augmented generation and indexes
- Azure AI Search — RAG overview and retrieval patterns
- OpenAI Developers — File search
- OWASP GenAI — LLM Top 10 2026
ตรวจหลักการและแหล่งอ้างอิง: 2 พฤศจิกายน 2026; ตารางและโฟลว์เป็นตัวอย่างออกแบบ ไม่ใช่การวัดผลระบบจริง
เลือกหัวข้อที่เกี่ยวข้องเพื่อทำความเข้าใจแนวคิดและข้อจำกัดก่อนนำไปใช้จริง
ดูบทความหมวดเทคโนโลยี ↗