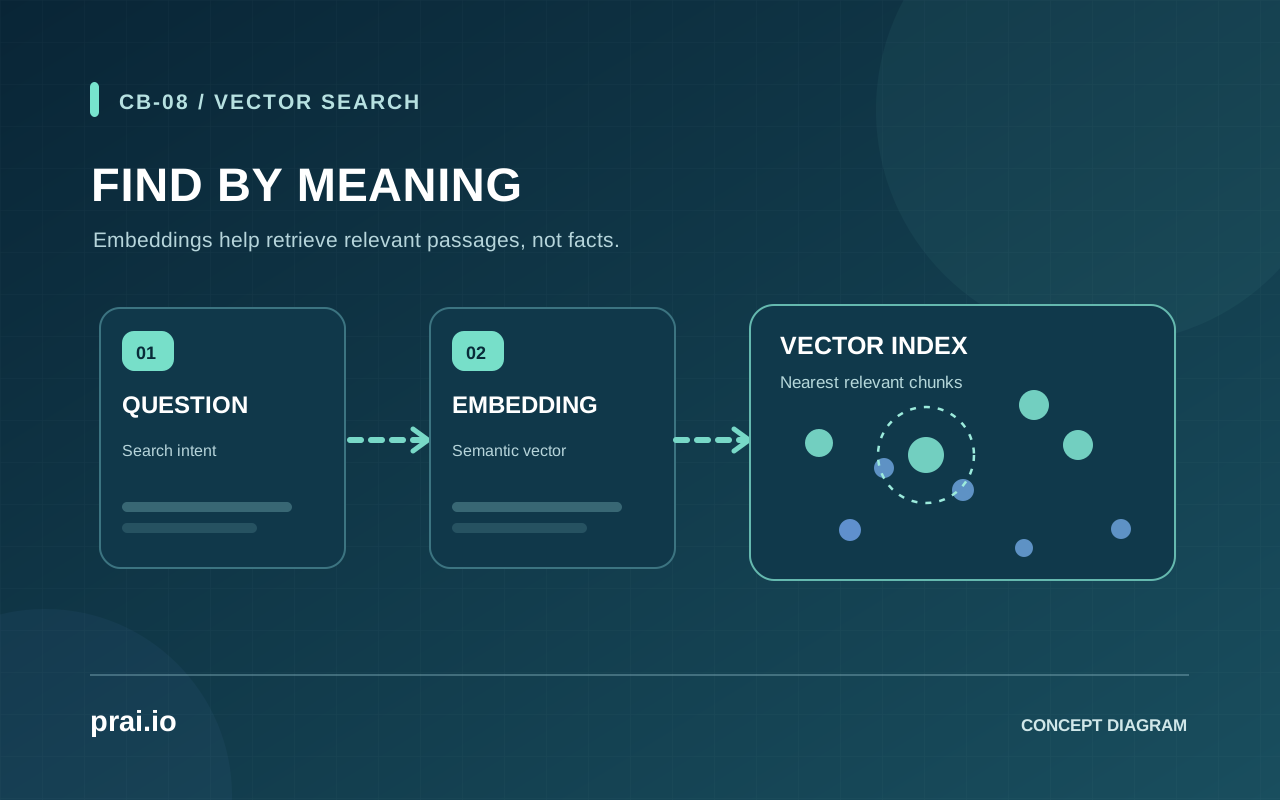
Embedding คือการแทนข้อความหรือข้อมูลเป็นชุดตัวเลข (Vector) เพื่อให้ระบบคำนวณความสัมพันธ์ด้านความหมาย ส่วน Vector Database / Vector Index คือส่วนจัดเก็บหรือจัดดัชนีเวกเตอร์เพื่อค้นรายการที่อยู่ใกล้กันตามเกณฑ์ที่กำหนด เทคโนโลยีนี้มีประโยชน์กับ Chatbot ที่ต้องค้นเอกสารมากกว่าหาจากคำตรงตัว แต่ไม่ได้เป็นส่วนประกอบบังคับของ Chatbot ทุกแบบ
ในระบบ RAG การค้นเป็นขั้นหนึ่งก่อนส่งข้อมูลให้ LLM ตอบ ดังนั้น Vector Search ไม่ใช่การสร้างคำตอบโดยตัวมันเอง และคะแนนความใกล้เคียงไม่ใช่คะแนนว่าข้อความในเอกสารถูกต้องหรือผู้ใช้ได้รับอนุญาตให้อ่าน
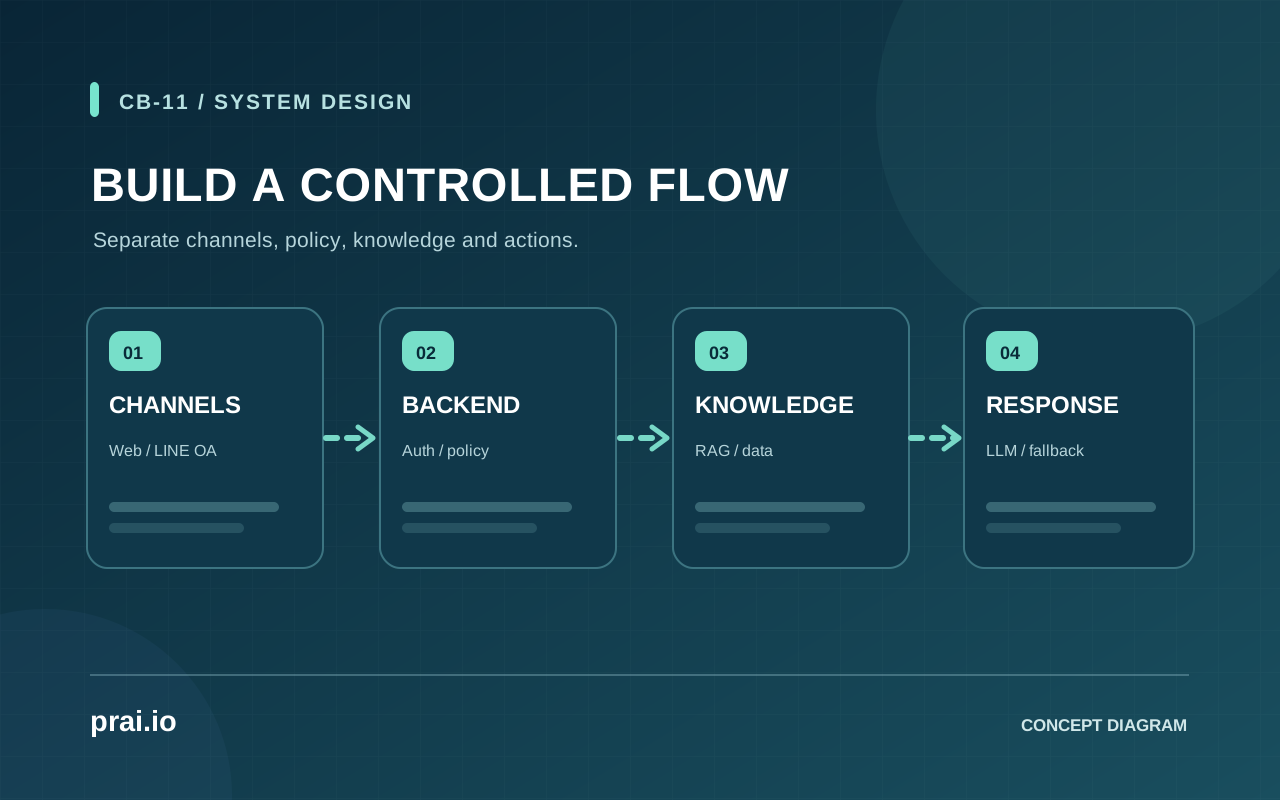
หน้านี้เน้นกลไก Retrieval และ Index หากสนใจ Pipeline ครบตั้งแต่เอกสารถึงคำตอบ อ่าน RAG สำหรับ AI Chatbot
Embedding แปลงข้อความเป็นเวกเตอร์อย่างไร
สมมติเอกสารหนึ่งเขียนว่า “วิธีแจ้งลาหยุดประจำปี” ขณะที่ผู้ใช้ถาม “ขอลาพักร้อนต้องทำอะไร” แม้คำไม่ตรงกัน โมเดล Embedding ที่รองรับภาษาและบริบทนั้นอาจจัดให้ข้อความสองชุดอยู่ใกล้กันในพื้นที่เวกเตอร์
การสร้างเวกเตอร์ไม่ใช่การแปลข้อความกลับไปกลับมาแบบตรงตัว แต่เป็นการเข้ารหัสคุณลักษณะบางอย่างเป็นตัวเลขหลายมิติ การเปรียบเทียบอาจใช้ Cosine Similarity, Dot Product หรือระยะทางแบบอื่นตามโมเดลและระบบ Index
สำหรับผู้พัฒนา จุดสำคัญคือ ต้องใช้โมเดล Embedding ที่สอดคล้องกันทั้งฝั่งจัดทำ Index และฝั่ง Query ความยาวเวกเตอร์ (Dimensions) และวิธีวัดระยะต้องตรงกัน การเปลี่ยนโมเดลโดยไม่วางแผนสร้าง Index ใหม่อาจทำให้ผลค้นแย่ลงหรือ Query ใช้งานไม่ได้
Vector Database ต่างจากฐานข้อมูลปกติหรือไม่
ฐานข้อมูลทั่วไปถนัดการเก็บรายการที่มีฟิลด์ชัดและการค้นแบบเงื่อนไข เช่น order_id = 123 หรือชื่อเอกสารตรงตัว ส่วน Vector Index เพิ่มความสามารถค้นความใกล้เคียงของเวกเตอร์ ซึ่งอาจทำในฐานข้อมูลที่รองรับ Extension/Index ประเภทนี้ หรือแยกเป็นบริการค้นเฉพาะก็ได้
ไม่จำเป็นต้องซื้อ Vector Database อีกระบบเสมอไป เพราะบางฐานข้อมูลมีเวกเตอร์ในตัว และบางงานใช้ Keyword Search แบบเดิมได้เหมาะกว่า ก่อนเลือกควรวัดขนาดข้อมูล การดูแล Index สิทธิ์เข้าถึง การลบ/อัปเดต และเวลาตอบสนองจากชุดคำถามที่ผู้ใช้มีจริง ถ้าต้องจัด Database ร่วมกับ Session และ API ควรอ่านภาพรวม Chatbot Architecture เพื่อไม่เอาดัชนีค้นไปแทนฐานข้อมูลธุรกรรม
ตัวอย่างเปรียบเทียบ:
| คำถาม | วิธีค้นที่เหมาะเริ่มต้น | เหตุผล |
|---|---|---|
| “สถานะ ORD-2046” | API/Exact Lookup | รหัสต้องตรงและข้อมูลต้องเป็นปัจจุบัน |
| “คู่มือเปิดสิทธิ์ SSO” | Keyword + Metadata | มีคำเฉพาะและชื่อระบบ |
| “อยากคืนเงินต้องเตรียมอะไร” | Semantic/Hybrid | อาจพิมพ์ต่างจากหัวข้อเอกสาร |
| “นโยบาย HR ของทีมฉัน” | Permission Filter + Search | สิทธิ์สำคัญกว่าคะแนนความคล้าย |
ตารางเป็น แนวทางเลือกที่เสนอ ไม่ใช่ผล Benchmark ที่เคยวัดจริง
Chunking: ทำไมไม่ Embedding ทั้ง PDF ก้อนเดียว
เอกสารหลายหน้าอาจมีหัวข้อที่ไม่เกี่ยวข้องกัน หากสร้างเวกเตอร์เดียวแทนทั้งไฟล์ ระบบอาจค้นเจอไฟล์ได้แต่ไม่รู้ว่าประโยคไหนตอบโจทย์ การแบ่งเอกสารเป็น Chunk ช่วยให้เลือกส่วนที่ตรงกว่า แต่ยังต้องรักษาบริบท เช่น หัวข้อแม่ เลขข้อ และข้อยกเว้นที่ต่อเนื่อง
แนวทางทดลองที่ไม่ผูกกับตัวเลขตายตัว:
- แยกตามโครงสร้าง Heading หรือ Section ก่อน ไม่ตัดกลางตารางหรือข้อตกลงสำคัญ
- บันทึกความสัมพันธ์ว่า Chunk มาจากไฟล์ไหน หัวข้อใด และเวอร์ชันใด
- ทดลองคำถามที่ต้องอาศัยสองย่อหน้าที่ต่อเนื่อง เพื่อตรวจว่าตัดข้อมูลสำคัญหายหรือไม่
- หาก Chunk จำนวนมากซ้ำกันให้ตรวจผล Recall และค่าใช้จ่ายก่อนเพิ่ม Overlap
ในเอกสารสแกนและ PDF ที่มีตารางซับซ้อน ขั้นตอนดึงข้อความอาจผิดตั้งแต่ก่อน Index เช่น แถวกับคอลัมน์สลับกัน จึงควรสุ่มตรวจข้อความต้นทาง ไม่คิดว่า Embedding แก้ปัญหา OCR หรือข้อมูลไม่ครบได้เอง
Metadata Filtering สำคัญพอ ๆ กับ Similarity
Vector Index ควรเก็บ Metadata เช่น document_id, version, language, tenant_id, access_scope, effective_date และ source_url ตามความจำเป็น
หากผู้ใช้เป็นพนักงานทีม A การค้นควรจำกัด Dataset/Scope ที่ได้รับอนุญาตก่อนผลถูกส่งให้โมเดล และต้องตรวจสิทธิ์อีกครั้งเมื่อผู้ใช้เปิดเอกสารจริง อย่าค้นทุกไฟล์แล้วให้โมเดลเป็นผู้ลบข้อความลับออกจากคำตอบ เพราะข้อมูลนั้นเข้าสู่ Context ไปแล้ว
คำว่า Filter ต้องตรวจตามความสามารถของ Engine ที่ใช้จริงว่าเป็น Pre-filter หรือ Post-filter และผลต่อ Recall อย่างไร สิทธิ์สำคัญควร enforce ใน Backend และชั้นดึงข้อมูล ไม่ใช่พึ่ง UI ที่ซ่อนบางรายการ
Similarity Score ไม่ใช่ความมั่นใจของคำตอบ
คะแนนการค้นขึ้นกับชนิดโมเดล วิธีคำนวณ และ Index จึงเปรียบคะแนนจากคนละระบบตรง ๆ ไม่ได้ ตัวอย่างตัวเลข 0.8 ที่บางคนเรียกว่า “มั่นใจ 80%” ไม่ใช่การตีความที่ถูกต้องเสมอ เพราะอาจเป็นค่า Cosine Similarity หรือคะแนนที่ผ่านกระบวนการปรับแต่งอื่น
แทนการตั้ง Threshold เดาสุ่ม ให้สร้างชุด Query ที่มี Ground Truth ว่าควรคืน Chunk ใด แล้ววัด Recall@k, Precision@k หรือ MRR ตามความเหมาะสม รวมถึง Query ที่ ไม่ควรมีคำตอบ เพื่อดูว่าระบบคืนสิ่งไม่เกี่ยวข้องมากเพียงใด
ในระบบภาษาไทย ควรทดสอบคำยืม คำสะกดหลายรูป คำทางการกับภาษาพูด และคำที่กำกวม หากเอกสารมีไทยปนอังกฤษต้องทดสอบ Cross-language Retrieval ด้วย ไม่เชื่อผล Demo ภาษาอังกฤษแทนข้อมูลจริง
Hybrid Search ควรใช้เมื่อใด
Hybrid Search ผสม Keyword กับ Vector เพื่อให้ได้ทั้งความสามารถจับรหัส/ชื่อเฉพาะและหาความหมายใกล้เคียง อาจเสริมด้วย Reranking ที่ประเมินผลค้นเพิ่มเติมก่อนส่งให้โมเดล
ตัวอย่างจำลอง: ผู้ใช้ถาม “ใครมีสิทธิ์ใช้ VPN บนเครื่องบริษัท” ดัชนี Keyword อาจจับ VPN และชื่อระบบ ส่วนเวกเตอร์ช่วยค้นหัวข้อ “การเข้าถึงเครือข่ายจากภายนอก” แล้วแอปรวมและจัดอันดับก่อนเลือกผลที่ผู้ใช้มีสิทธิ์อ่าน
Microsoft อธิบายการเตรียม Chunk, Vectorization และ Hybrid Queries ใน Azure AI Search RAG overview ส่วน OpenAI File Search เป็นตัวอย่างบริการค้นไฟล์แบบ Hosted ที่ลดภาระการพัฒนา Index เอง; อย่างไรก็ดีแต่ละแพลตฟอร์มมีการกำหนดสิทธิ์และ Metadata ต่างกัน
เช็กลิสต์ทดลอง Retrieval
ชุดทดสอบเริ่มต้นควรมีคำถามที่ใช้คำตรงและคำต่างจากเอกสาร คำที่มีหลายคำตอบ คำที่มีวันที่/เวอร์ชันกำกับ คำถามข้ามแผนก และคำถามที่ไม่มีแหล่งรองรับ
บันทึก query, รายการเอกสารที่ควรเจอ, ผลค้นที่คืนจริง, สิทธิ์ผู้ถาม, เวอร์ชันดัชนี และวันทดสอบ แล้วค่อยตัดสินใจเลือก Keyword, Vector หรือ Hybrid จากหลักฐาน ไม่จำเป็นต้องตั้งเป้าเปอร์เซ็นต์ก่อนมีข้อมูล
เกณฑ์หยุดที่สำคัญ: หากผลค้นปะปนเอกสารที่ผู้ใช้ไม่มีสิทธิ์เห็น ให้หยุดแก้ Access Control ก่อนปรับคะแนนหรือเลือกโมเดลใหม่ และดูวิธีแยกสิทธิ์ของเอกสารกับข้อมูลสนทนาใน Chatbot Security
คำถามที่พบบ่อย
Vector Database จำเป็นสำหรับทุก AI Chatbot ไหม
ไม่จำเป็น Bot ที่ใช้เมนู FAQ หรือเรียก API ตรงตามรหัสอาจไม่ต้องใช้ Vector Search เลย
Embedding ต่างจาก LLM อย่างไร
Embedding สร้าง Representation สำหรับเปรียบเทียบและค้น ส่วน LLM ใช้บริบทสร้างข้อความตอบ ทั้งสองทำงานร่วมกันได้แต่ไม่ได้มีหน้าที่เหมือนกัน
เปลี่ยน Embedding Model แล้วใช้ Index เดิมได้ไหม
ไม่ควรสมมติว่าได้ เพราะมิติและความหมายของเวกเตอร์อาจต่างกัน ต้องตรวจ Compatibility และมักต้องสร้าง/ทดสอบ Index ใหม่
แหล่งอ้างอิง
- Azure AI Search — RAG, Chunking, Vectorization และ Hybrid Search
- Microsoft Foundry — Retrieval augmented generation
- OpenAI Developers — File search
ตรวจเอกสารต้นทาง: 2 พฤศจิกายน 2026; ตารางและตัวอย่างเป็นวิธีออกแบบ ไม่ใช่การอ้างผลทดสอบดัชนีจริง
เลือกหัวข้อที่เกี่ยวข้องเพื่อทำความเข้าใจแนวคิดและข้อจำกัดก่อนนำไปใช้จริง
ดูบทความหมวดเทคโนโลยี ↗