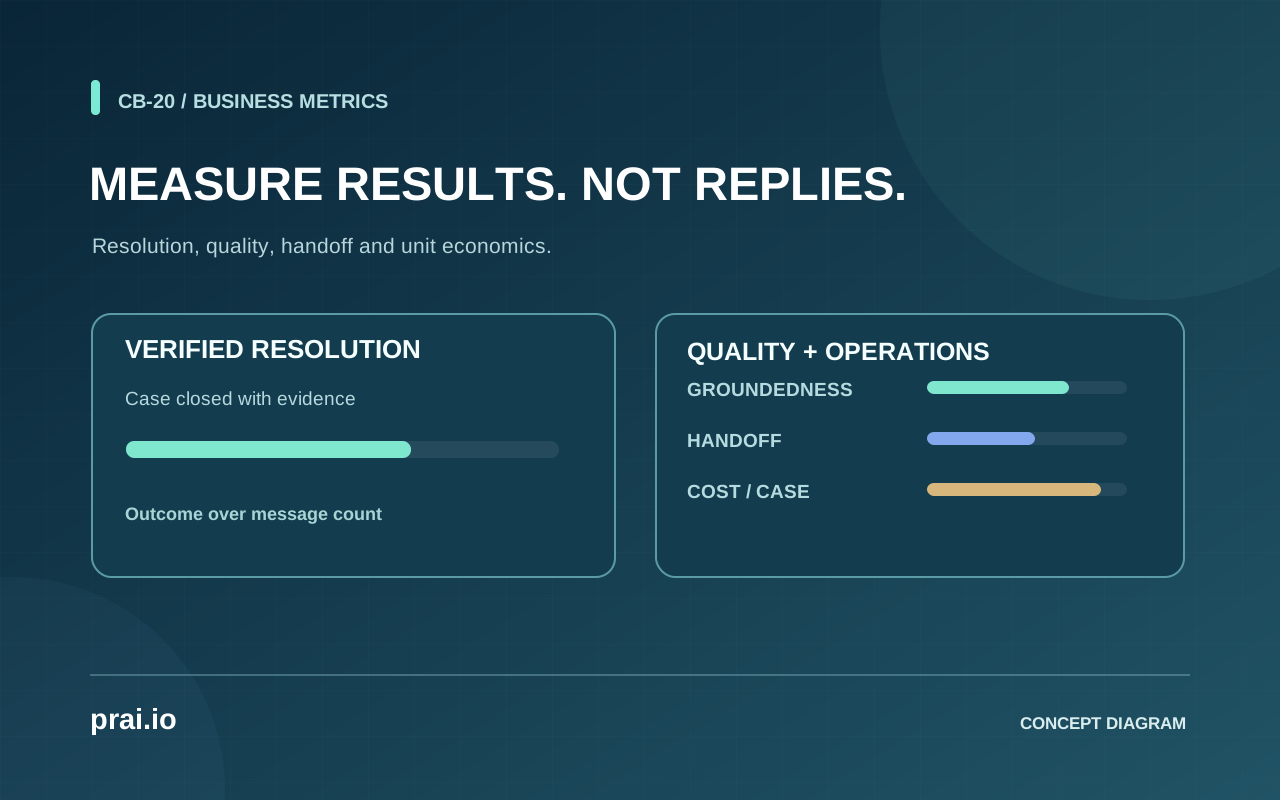
Chatbot KPI ควรบอกว่าระบบ ช่วยให้ผู้ใช้ทำงานสำเร็จและได้รับคำตอบที่ถูกต้องจริงหรือไม่ ไม่ใช่เพียงจำนวนข้อความที่ Bot ส่ง หรือจำนวนครั้งที่บทสนทนาไม่ถูกส่งต่อเจ้าหน้าที่ การไม่ส่งต่ออาจหมายถึงผู้ใช้แก้ปัญหาได้แล้ว หรืออาจหมายถึงผู้ใช้ยอมแพ้และออกจากแชต
การสร้าง Dashboard ที่มีประโยชน์จึงต้องกำหนด นิยามหน่วยนับ (Session/Case/Message), วิธีนับผลสำเร็จ, แหล่งยืนยันความถูกต้อง และการวัดเทียบ Baseline ก่อนสรุปผล
บทความนี้เน้นการวัดหลังนำ Chatbot ใช้จริง ต่างจาก Chatbot Architecture ที่เน้นวางระบบ หรือ ค่าใช้จ่าย AI Chatbot ที่เน้น Budget Model
KPI ควรเชื่อมกับเป้าหมายธุรกิจใด
เริ่มจาก Use Case ที่ Bot รับผิดชอบและผลที่ผู้ใช้คาดหวัง เช่น ผู้ใช้อยากทราบเวลาบริการ ต้องได้ข้อมูลถูกต้อง ลูกค้าต้องการติดตาม Order ต้องเห็นสถานะที่ยืนยันจากระบบ และคนร้องเรียนต้องได้รับ Ticket ให้ติดตามได้
| เป้าหมาย | Outcome ที่ควรวัด | สิ่งที่ไม่ควรใช้แทน |
|---|---|---|
| ตอบ FAQ ทั่วไป | ผู้ใช้ได้คำตอบถูก/ยืนยันได้ | จำนวนข้อความที่ Bot ตอบ |
| เช็กคำสั่งซื้อ | API ยืนยันว่าแสดงสถานะให้เจ้าของรายการ | Bot พิมพ์ว่า “ตรวจแล้ว” |
| ส่ง Lead ให้ฝ่ายขาย | CRM ยืนยันสร้างรายการและมี Owner | Bot พูดว่า “รับเรื่องแล้ว” |
| ขอคุยเจ้าหน้าที่ | Ticket/Queue ยืนยันได้รับคำขอ | การแสดงปุ่มติดต่อคน |
| ลดเวลาค้นคู่มือ | ผู้ใช้ทำ Task สำเร็จจากหลักฐานที่ถูกต้อง | Retrieval คืนเอกสารมาได้จำนวนมาก |
ชุดตัวอย่างเป็น กรอบเลือก KPI ไม่ใช่ผลสำรวจหรือรายงานประสิทธิภาพของ Prai.io
Resolution Rate ต่างจาก Containment Rate อย่างไร
Verified Resolution Rate คือสัดส่วนเคสที่มีหลักฐานว่าปัญหาของผู้ใช้จบจริงในกลุ่มเคสที่มีสิทธิ์นับ ส่วน Containment Rate อาจหมายถึงสัดส่วนเคสที่ไม่ถูกส่งต่อคนในช่วงเวลาหนึ่ง ซึ่งไม่ยืนยันว่าแก้ปัญหาสำเร็จทุกเคส
สูตรแบบเสนอสำหรับองค์กร (ต้องประกาศนิยามหน่วยนับก่อนใช้):
verified_resolution_rate =
  verified_resolved_eligible_cases
  / total_eligible_cases * 100

containment_rate =
  cases_without_handoff
  / total_eligible_cases * 100
ถ้าผู้ใช้หยุดตอบแล้วปิดหน้าต่าง Chat UI อย่าให้ระบบนับว่า “จบแล้ว” โดยอัตโนมัติโดยไม่มีหลักฐาน ผลวัดอาจเอนเอียงเมื่อผู้ใช้เข้ามาหาคำตอบสั้น ๆ แล้วหายไป หรือมีการนับ Session ที่ซ้ำกัน
Microsoft Copilot Studio — Business Value Metrics Reference อธิบาย Resolution, Deflection, Escalation และ Abandon ตามกติกาของแพลตฟอร์ม เอกสารนี้ช่วยให้เห็นว่า แต่ละแพลตฟอร์มอาจมีวิธีนับผลต่างกัน ดังนั้นเมื่อเปรียบเทียบระบบขององค์กรกับเครื่องมืออื่นควรตรวจนิยามก่อน
Escalation Rate กับ Human Handoff ตีความอย่างไร
Escalation Rate คือสัดส่วนการสนทนาหรือเคสที่ส่งต่อเจ้าหน้าที่ในช่วงที่กำหนด โดยต้องระบุว่าใช้ฐานนับเป็น Session, Engaged Session หรือ Eligible Case
escalation_rate =
  eligible_cases_escalated_to_human
  / total_eligible_cases * 100
การส่งต่อคน ไม่ใช่ความล้มเหลวทุกครั้ง หากลูกค้าขอคืนเงินตามกรณียกเว้น หรือถามข้อมูลที่ Bot ไม่ควรเข้าถึง การส่งต่ออย่างถูกต้องอาจเป็นผลสำเร็จด้านความปลอดภัยและประสบการณ์ลูกค้า
Google Cloud Virtual Agent Metrics แสดง Escalation Rate, Turns per Session และ Tool Failure Rate เป็นตัวชี้วัดการดำเนินงาน แต่ไม่ได้บอกว่าเป้าหมาย Escalation ต้องเป็นศูนย์
ตัวอย่างคำนวณ KPI จากเคสสมมติ 200 รายการ
สมมติให้มี 200 Eligible Cases ในหนึ่งเดือน หลังคัดรายการที่ไม่เข้าเงื่อนไขนับออกแล้ว โดยในระบบจำลองนี้พบว่ามี 120 เคสที่ ตรวจหลักฐานแล้วว่าแก้ปัญหาสำเร็จโดยไม่ส่งต่อคน, อีก 30 เคสที่ ไม่ส่งต่อคนแต่ยังไม่มีหลักฐานว่าจบ, และ 50 เคสที่ ส่งต่อให้เจ้าหน้าที่ ทั้งสามกลุ่มไม่ทับซ้อนกันและรวมเป็น 200 เคสพอดี นี่เป็นเพียงชุดข้อมูลสมมติ ไม่ใช่ผลวัดจากลูกค้าหรือแพลตฟอร์มใด
| ตัวชี้วัด | สูตรจากตัวอย่าง | ผลตัวอย่าง |
|---|---|---|
| Verified Resolution Rate | 120 ÷ 200 × 100 | 60% |
| Containment Rate | (120 + 30) ÷ 200 × 100 | 75% |
| Escalation Rate | 50 ÷ 200 × 100 | 25% |
| No-handoff แต่ยังไม่ยืนยันว่าจบ | 30 ÷ 200 × 100 | 15% |
ดังนั้น Containment 75% ไม่ใช่ Resolution 75% เพราะมี 30 เคสที่ไม่ถูกส่งต่อแต่ยังตรวจผลสำเร็จไม่ได้ และเคสที่ส่งต่อ 50 รายการไม่ได้แปลว่าล้มเหลวเสมอไป หากเป็นเรื่องที่ต้องอนุมัติจากคน
สมมติแยกอีกว่ามีผู้ตอบแบบสอบถามความพึงพอใจที่ถูกต้อง 60 ราย และ 45 รายผ่านเกณฑ์เชิงบวกที่องค์กรประกาศก่อนวัด จะได้ CSAT = 45 ÷ 60 × 100 = 75% หากเชิญตอบแบบสอบถามครบ 200 เคส จะมี Survey Response Rate = 60 ÷ 200 × 100 = 30% ต้องระบุฐานนับและ Selection Bias ของกลุ่มที่ไม่ตอบด้วย
ถ้าสมมติว่าต้นทุนดำเนินงานสำหรับ ช่วงและขอบเขตเดียวกัน เท่ากับ 24,000 บาท จะได้ Cost per Eligible Case = 24,000 ÷ 200 = 120 บาท/เคส และ Cost per Verified Resolution = 24,000 ÷ 120 = 200 บาท/เคสที่ยืนยันว่าจบ ตัวเลขทั้งหมดเป็นข้อมูลฝึกคำนวณ ไม่ใช่ KPI, SLA, ค่าใช้จ่าย หรือ Benchmark ของ Prai.io
Answer Accuracy และ Groundedness ต่างกันอย่างไร
Accuracy ของคำตอบวัดความถูกต้องเมื่อเทียบกับข้อมูลจริงที่ได้รับอนุมัติ ส่วน Groundedness วัดว่าคำตอบอิงหลักฐานที่ระบบมีหรือไม่ หากโมเดลยกเอกสารมาถูกชื่อแต่สรุปเงื่อนไขผิด ถือว่ามี Citation แต่ยังตอบผิด
การทดสอบที่เหมาะควรมีชุดคำถามที่เจ้าของเนื้อหารับรองพร้อมคำตอบอ้างอิงและกรณีไม่ควรตอบ เช่น เอกสารหมดอายุ คำถามไม่อยู่ในความรู้ หรือข้อมูลผู้ใช้ไม่มีสิทธิ์เข้าถึง
ตัวอย่างสมมติ: หาก Bot บอกเวลาเปิดบริการถูกแต่ใส่วันหยุดผิดเพราะใช้เอกสารเก่า ให้บันทึก Error ที่ต้นทางความรู้ ไม่ตีความว่า LLM ตอบคล่องจึงผ่านการตรวจ
Google Cloud — Methodical Agent Evaluation เสนอการดูทั้งผลสำเร็จ การใช้เครื่องมือ และด้านความน่าเชื่อถือ โดยทดสอบเป็นกรณีที่ตรวจได้แทนการพึ่งคะแนนความมั่นใจที่โมเดลบอกเอง
Customer Satisfaction (CSAT) ต้องเก็บอย่างไร
CSAT มักใช้แบบสอบถามหลังบทสนทนาจบเพื่อให้ผู้ใช้แสดงระดับความพึงพอใจ แต่ต้องกำหนดว่าคำตอบเชิงบวกคือระดับไหน และแสดงจำนวนผู้ตอบด้วยเสมอ ไม่ใช่เอาคะแนนจากผู้ตอบไม่กี่คนไปอ้างแทนผู้ใช้ทั้งหมด
ตัวอย่างสูตรเมื่อใช้คำถามพึงพอใจที่มีเกณฑ์เชิงบวกกำหนดไว้:
CSAT_positive_percentage =
  positive_survey_responses
  / valid_survey_responses * 100
ควรรายงาน Response Rate และจำนวนผู้ตอบควบคู่กันด้วย เพราะคนที่เจอปัญหาและออกจากระบบก่อนเห็นคำถามประเมิน อาจไม่ถูกนับในชุดข้อมูล
หากต้องใช้คะแนนความเห็นเพื่ออัปเดตระบบ ให้รวมกับผลการตรวจข้อเท็จจริงด้วย ไม่ทำให้คะแนนชอบคำตอบกลายเป็นหลักฐานว่า Bot ให้ข้อมูลถูกต้อง
Latency ควรวัดที่จุดไหนบ้าง
เวลาตอบมีหลายชั้น ตั้งแต่ Browser/Channel ส่งข้อความมาถึง Backend, ตรวจสิทธิ์, ค้นเอกสาร, เรียกโมเดล, เรียก Tool และตอบกลับผู้ใช้ การวัดแค่เวลา Model Inference อาจซ่อนจุดรอที่ผู้ใช้รู้สึกจริง
ควรแยก First Response Time และ End-to-end Task Completion Time รวมถึง P50/P95 ของ Latency เพื่อดูกรณีที่ช้ากว่าปกติ แต่ไม่กำหนดเป้าหมายตัวเลขมาตรฐานโดยไม่มีข้อมูลระดับบริการจริง
สำหรับระบบที่ต้องส่งมนุษย์รับช่วง ให้แยก เวลารอเจ้าหน้าที่จริง ออกจากเวลาที่ Bot ส่งข้อความว่า “กำลังติดต่อทีม” เพราะสองเหตุการณ์นี้ไม่ใช่สิ่งเดียวกัน
Tool Failure Rate และความปลอดภัยมี KPI อะไร
ถ้า Bot เรียก API Order, CRM หรือ Ticket ให้เก็บอัตรา Tool Call ที่ล้มเหลว, Permission Denied ที่ควรปฏิเสธ, Retry ที่เกิดซ้ำ และเหตุการณ์ที่พยายามอ่านข้อมูลข้ามผู้ใช้
Permission Denied ที่ถูกต้องไม่ใช่ System Error หากผู้ใช้ A ขอ Order ของผู้ใช้ B ระบบที่ปฏิเสธคือผลสำเร็จด้าน Authorization ไม่ใช่ Failure ที่ควรแก้โดยให้ Bot มีสิทธิ์อ่านทุก Order
ต้องแยกกรณีนี้ออกจาก Tool Failure เพราะ Server ล่ม, Timeout หรือข้อมูลปลายทางผิด และมีขั้นตอน Incident Response เมื่อพบข้อมูลรั่วหรือพฤติกรรมเกินสิทธิ์ อ่าน Chatbot Security เพิ่มเติม หากระบบสร้าง Lead หรือ Ticket ต้องตรวจด้วยว่าปลายทางรับข้อมูลสำเร็จจริงตามแนวทาง Chatbot CRM Integration ไม่ใช้เพียงข้อความยืนยันของ Bot
Cost per Conversation กับ Cost per Resolved Case
จำนวนข้อความที่ Bot ตอบไม่ใช่จำนวนปัญหาที่จบ หากต้องประเมินประสิทธิภาพทางงบ ให้แยก Cost per Conversation ออกจาก Cost per Verified Resolved Case
cost_per_conversation =
  total_operating_cost_for_period
  / eligible_conversations

cost_per_verified_resolution =
  total_operating_cost_for_period
  / verified_resolved_cases
หากไม่มีเคสที่จบจริงในช่วงวัด ห้ามหารด้วยศูนย์หรือรายงานเป็น 0 บาท ควรแสดงว่าไม่มีข้อมูลพอหรือไม่สามารถคำนวณได้ และระบุรายการต้นทุนที่รวมอยู่ในตัวเศษ เช่น Model, Retrieval, Hosting, Support และคนดูแล
ใช้ข้อมูลจาก Billing/Usage/Logs ที่เกี่ยวข้อง ไม่เอาราคาโฆษณาของผู้ให้บริการมาถือเป็นต้นทุนของระบบจริง และสามารถอ่านสูตร TCO ต่อได้ที่ ค่าใช้จ่าย AI Chatbot
ออกแบบ Dashboard อย่างไรไม่ให้ตีความผิด
Dashboard ที่ดีควรแสดง ฐานนับ ช่วงเวลา แหล่งข้อมูล และจำนวนเหตุการณ์ ทุก KPI แยกแนวโน้มการใช้ระบบออกจาก Outcome เช่น การที่ข้อความเพิ่มขึ้นอาจเป็นทั้งเพราะลูกค้าเพิ่มและเพราะ Bot ตอบวนลูป ไม่ใช่ความสำเร็จอัตโนมัติ
| กลุ่ม KPI | ตัวอย่าง | ข้อควรอ่านร่วม |
|---|---|---|
| Outcome | Verified Resolution Rate | นับเฉพาะเคสที่ตรวจผลได้ |
| Quality | Accuracy/Groundedness | วิธีสุ่มตรวจและเวอร์ชันความรู้ |
| Human | Escalation, Wait Time | คิวจริงและเหตุผลส่งต่อ |
| Experience | CSAT, Response Rate | จำนวนคนตอบ/Selection Bias |
| Reliability | Tool Failure, P95 Latency | จัดประเภท Error |
| Economics | Cost per Resolution | ขอบเขตต้นทุนและช่วงเวลา |
ก่อนนำตัวเลขไปใช้ตัดสินใจลดเจ้าหน้าที่ ควรมีชุดข้อมูลที่ผ่านการตรวจความเป็นส่วนตัวและผู้รับผิดชอบรับรอง ไม่เอาเนื้อหาบทสนทนาส่วนตัวทั้งหมดขึ้น Dashboard โดยไม่จำเป็น
Review Loop ทำอย่างไรเพื่อให้ KPI ช่วยปรับปรุง Bot
วางรอบตรวจที่ทีมทำได้จริง เช่น ประชุมทบทวนเคสที่ Bot ตอบผิด ค้นเอกสารไม่พบ หรือส่งต่อคนบ่อย แล้วแยก Root Cause ว่าอยู่ที่ FAQ ที่ไม่ครบ, Retrieval ไม่เจอข้อมูล, API ล่ม, Permission หรือปัญหาประสบการณ์ผู้ใช้
เมื่อแก้แล้วให้เพิ่มกรณีทดสอบเดิมกลับเข้า Regression Suite ก่อน Publish เวอร์ชันใหม่ หากข้อมูลเปลี่ยนต้องให้เจ้าของข้อมูลอนุมัติ ไม่ให้ LLM สรุปข้อร้องเรียนเป็นกฎใหม่เองโดยอัตโนมัติ
Google Cloud CX Agent Studio — Evaluation อธิบายแนวทาง Test Cases, Simulation และการตรวจ Tool Correctness ซึ่งเป็นตัวอย่างกรอบประเมินที่ควรนำไปปรับให้เหมาะกับระบบจริง ไม่ต้องใช้แพลตฟอร์มเดียวกันเพื่อยึดหลักการตรวจย้อนกลับได้
Checklist ก่อนรายงานผู้บริหาร
- นิยาม Session/Case/Message และช่วงวัดตรงกันทุกทีม
- แสดง Verified Resolution แยกจาก Containment/No Handoff
- Escalation มีเหตุผลประกอบ ไม่สรุปว่าไม่ดีทุกกรณี
- ตัวอย่างคำตอบผิดมีหลักฐานและแยกตามประเภทความเสียหาย
- CSAT แสดงจำนวนคนตอบและ Response Rate
- ต้นทุนมีขอบเขตและไม่มีการหารด้วยศูนย์
- ค่า Latency ระบุจุดเริ่ม/จุดสิ้นสุดของการวัด
- มี Baseline และแยกเหตุการณ์ที่ปริมาณงานเปลี่ยน
- รายงานแหล่งข้อมูลและเจ้าของตัวชี้วัด
- มีการกำหนด Action เมื่อพบสัญญาณผิดปกติ
คำถามที่พบบ่อย
Handoff Rate สูง แปลว่า Bot ไม่ดีเสมอไปไหม
ไม่ ถ้าเคสส่วนใหญ่ต้องตรวจสิทธิ์หรืออนุมัติจากคน การส่งต่อที่ถูกต้องอาจเป็นวัตถุประสงค์ของระบบ ต้องดูประเภทคำถามและเหตุผลประกอบ
Bot ตอบได้ทุกคำถามถือว่าประสบความสำเร็จหรือไม่
ไม่ ต้องตรวจว่าคำตอบถูกและผู้ใช้ได้ผลจริง รวมถึงไม่มีข้อมูลหรือธุรกรรมที่เปิดเผยเกินสิทธิ์
ต้องตั้ง KPI เป้าหมายกี่เปอร์เซ็นต์
ใช้ Baseline, ความเสี่ยงและเป้าหมายธุรกิจจริงก่อน ไม่ควรคัดลอก Benchmark อุตสาหกรรมที่ไม่มีแหล่งอ้างอิงหรือใช้ฐานนับต่างกัน
แหล่งอ้างอิง
- Microsoft Copilot Studio — Agent business value metrics
- Google Cloud — Virtual agent operational metrics
- Google Cloud — Methodical agent evaluation
- Google Cloud — CX Agent Studio evaluation
- Shopify Help Center — Providing online customer service
ตรวจแหล่งอ้างอิง: 2 พฤศจิกายน 2026; นิยามและสูตรเป็นกรอบการวัดที่เสนอ ไม่ใช่ Benchmark หรือผลการวัดของระบบ Prai.io ที่เปิดใช้จริง
เลือกหัวข้อที่เกี่ยวข้องเพื่อทำความเข้าใจแนวคิดและข้อจำกัดก่อนนำไปใช้จริง
ดูบทความหมวดเทคโนโลยี ↗