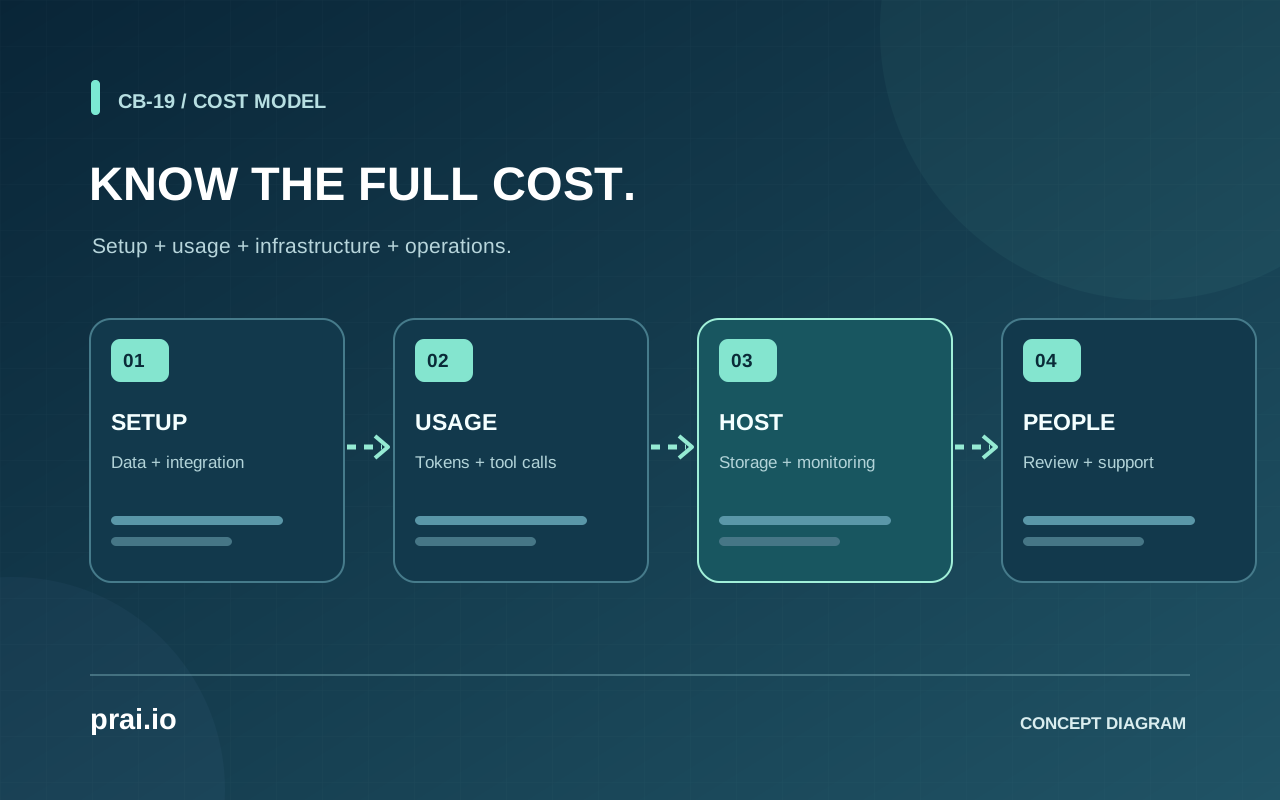
ค่าใช้จ่าย AI Chatbot ไม่ได้มีราคาเดียวสำหรับทุกกิจการ เพราะขึ้นกับว่าต้องตอบ FAQ เท่านั้นหรือเชื่อมระบบธุรกรรม มีข้อมูลให้อ้างอิงมากเท่าใด ใช้ช่องทางใด และต้องมีคนรับช่วงหรือดูแลความปลอดภัยระดับไหน การประเมินงบที่ตรวจสอบได้ควรแยก ค่าเริ่มต้น (One-time), ค่าใช้ตามปริมาณ (Variable) และ ค่าใช้จ่ายประจำ (Recurring) เสมอ
บทความนี้ไม่ได้เสนอราคาขายของ Prai.io หรือใบเสนอราคาจากผู้ให้บริการใด และ ไม่ตั้งราคาปัจจุบันของโมเดลเป็นตัวเลขคงที่ เพราะราคาอาจเปลี่ยนตามโมเดล ระดับความเร็ว วิธีประมวลผล พื้นที่จัดเก็บและเงื่อนไขสัญญา ควรเปิด หน้าราคา API ของ OpenAI หรือหน้าราคาผู้ให้บริการที่เลือกในวันที่คำนวณจริง
หากยังไม่รู้ว่าจะสร้าง Bot แบบใด อ่าน Chatbot สำหรับ SME หรือ วิธีสร้าง Chatbot บนเว็บไซต์ ก่อน บทความนี้จะลงรายละเอียดเรื่อง Cost Model และงบที่ต้องเผื่อ โดยไม่ปะปนกับการวัดผลตอบแทน
ค่าพัฒนาเริ่มต้นประกอบด้วยอะไร
ค่า Setup ไม่ใช่แค่เขียนกล่องข้อความ เพราะก่อนเปิดใช้ต้องจัดข้อมูล ทดสอบสิทธิ์ วาง Fallback และตรวจว่าระบบตอบผิดอย่างไร คำขอเชื่อม Order หรือ CRM เพิ่มส่วนงาน Backend/Integration มากกว่าการตอบ FAQ สาธารณะ
| งานเริ่มต้น | ตัวแปรหลัก | วิธีประเมินที่ตรวจสอบได้ |
|---|---|---|
| วิเคราะห์ความต้องการ | จำนวนช่องทาง/ชนิดคำถาม | แยก Use Cases กับข้อยกเว้น |
| เตรียมฐานความรู้ | จำนวนเอกสารและความซ้ำ | ประเมินเวลาตรวจโดยเจ้าของข้อมูล |
| Chat UI / Channel Adapter | เว็บไซต์, LINE, Messenger ฯลฯ | ดูกติกา API/UX แต่ละช่องทาง |
| เชื่อมระบบธุรกิจ | Order, CRM, Ticket | ประเมิน API, Auth และ Error Cases |
| Security / Privacy | สิทธิ์ผู้ใช้และข้อมูลอ่อนไหว | วาง Access Control และ Retention |
| Test & Release | กรณีปกติ/ผิดพลาด/ข้อมูลเก่า | คิดเวลา QA และ Acceptance |
หากหน่วยงานไม่มีผู้รับผิดชอบข้อมูลหรือไม่มี API ที่ต้องใช้ ก็ต้องนับเวลาทำสิ่งเหล่านี้ใน Scope ไม่ใช่สมมติว่าค่าใช้จ่ายจะเป็นศูนย์เพราะได้โมเดลราคาถูก
ค่ารายเดือนของโมเดล AI คิดอย่างไร
ผู้ให้บริการโมเดลข้อความหลายแห่งคิดจาก Token ที่ประมวลผล โดยแยก Input (คำถาม บริบท เอกสาร คำสั่ง) และ Output (ข้อความที่โมเดลตอบ) ซึ่งอาจมีราคาไม่เท่ากัน นอกจากนี้บางบริการมี Cached Input หรือโหมด Batch ที่คิดราคาแตกต่าง
สูตรแนวคิดสำหรับการประมาณค่าประมวลผลข้อความหนึ่งเดือน:
model_cost =
  (monthly_input_tokens  / price_unit_tokens) * input_rate
+ (monthly_output_tokens / price_unit_tokens) * output_rate

monthly_input_tokens  = calls_per_month * avg_input_tokens_per_call
monthly_output_tokens = calls_per_month * avg_output_tokens_per_call
คำเตือน: price_unit_tokens ต้องตรงกับหน่วยที่หน้า Pricing ระบุ เช่น ราคาต่อหนึ่งล้าน Token ไม่ใช่ต่อหนึ่ง Token; Input Rate และ Output Rate ต้องอ้างสกุลเงินเดียวกันและ Tier/Model ที่ใช้งานจริง
หากมี Tool, การเรียกโมเดลหลายรอบ การค้นเอกสาร หรือการ Retry ให้ใช้จำนวน Calls จริง ไม่ใช่แค่จำนวนข้อความที่ผู้ใช้ส่ง เพราะหนึ่งข้อความอาจเรียกโมเดลหลายครั้ง หรือบางคำถามไม่ต้องเรียกโมเดลเลย
ตาราง Scenario โดยไม่ใส่ราคาสมมติเป็นราคาเสนอขาย
ตัวอย่างนี้เป็น รูปแบบ Spreadsheet สำหรับทดลอง ไม่ใช่การประมาณว่าลูกค้าของ Prai.io ต้องจ่ายเท่าไร
| ตัวแปร | ทดลองขนาดเล็ก | การใช้งานมากขึ้น | แหล่งที่ต้องกรอก |
|---|---|---|---|
| ข้อความผู้ใช้ต่อเดือน | M_small |
M_large |
Traffic / Logs ที่ไม่เปิดข้อมูลส่วนตัว |
| Calls ต่อข้อความ | C_small |
C_large |
Trace จาก Workflow |
| Input Token ต่อ Call | I_small |
I_large |
Provider Usage |
| Output Token ต่อ Call | O_small |
O_large |
Provider Usage |
| Input/Output Rate | R_in, R_out |
R_in, R_out |
Pricing ณ วันที่ประเมิน |
| Tool/Vector/Workflow | T_small |
T_large |
รายงานบริการที่ใช้ |
| Hosting/Support | F_small |
F_large |
งบทีมและใบเสนอราคาจริง |
คำนวณจากค่า ที่ธุรกิจกรอกจริง โดยตรวจว่า Calls, Tokens, สกุลเงินและช่วงเวลาอยู่หน่วยเดียวกัน หากให้ฝ่ายบริหารเห็นตารางควรแยก Best/Base/Stress Case พร้อมสมมติฐานว่าข้อความอาจเพิ่มในช่วงโปรโมชั่นหรือระบบมี Error/Retry มากกว่าปกติ
ตัวอย่างคำนวณต้นทุนหนึ่งเดือนจากตัวเลขสมมติ
สมมติว่า ธุรกิจตัวอย่างที่ไม่มีอยู่จริง ได้รับข้อความแชตเดือนละ 8,000 ข้อความ และออกแบบ Workflow ให้เรียกโมเดลเฉลี่ย 1.25 ครั้งต่อข้อความ เท่ากับ 10,000 Model Calls ต่อเดือน สมมติอีกว่าแต่ละ Call ใช้ Input เฉลี่ย 1,200 Tokens และ Output เฉลี่ย 250 Tokens
เพื่อแสดงวิธีคำนวณเท่านั้น จะกำหนดราคา สมมติเป็นเงินบาท ที่ 100 บาทต่อหนึ่งล้าน Input Tokens และ 400 บาทต่อหนึ่งล้าน Output Tokens ตัวเลขสองตัวนี้ ไม่ใช่ราคาปัจจุบันของ OpenAI หรือผู้ให้บริการรายใด และไม่ใช่อัตราที่ Prai.io เสนอขาย
| รายการ | สูตรจากสมมติฐาน | ผลคำนวณจำลอง |
|---|---|---|
| Model Calls | 8,000 ข้อความ × 1.25 Calls | 10,000 Calls |
| Input Tokens | 10,000 × 1,200 | 12,000,000 Tokens |
| Output Tokens | 10,000 × 250 | 2,500,000 Tokens |
| ค่า Input | 12,000,000 ÷ 1,000,000 × 100 บาท | 1,200 บาท |
| ค่า Output | 2,500,000 ÷ 1,000,000 × 400 บาท | 1,000 บาท |
| ค่าโมเดลรวม | 1,200 + 1,000 | 2,200 บาท |
| ค่า Workflow/Tools สมมติ | กำหนดเพื่อฝึกทำงบ | 600 บาท |
| ค่า Hosting สมมติ | กำหนดเพื่อฝึกทำงบ | 1,200 บาท |
| ค่าแรงดูแล/ตรวจคำตอบสมมติ | กำหนดเพื่อฝึกทำงบ | 4,000 บาท |
| ค่าดำเนินงานเดือนตัวอย่าง | 2,200 + 600 + 1,200 + 4,000 | 8,000 บาท |
หากสมมติให้มีค่าจัดตั้งระบบครั้งเดียวอีก 15,000 บาท เดือนแรกจะคิดเป็น 23,000 บาท (15,000 + 8,000) ส่วนเดือนปกติที่ไม่เกิดค่าเริ่มต้นซ้ำจะเป็น 8,000 บาทตามสมมติฐานนี้เท่านั้น ตัวอย่างไม่ได้รวมภาษี ค่าส่งข้อความรายช่องทาง ค่าเครื่องมือเพิ่มเติม ค่าเปลี่ยนแปลงขอบเขต หรือค่าใช้จ่ายที่ไม่ได้สมมติไว้
วิธีนำไปใช้จริง: แทนค่า 100/400 บาทด้วย Rates ของโมเดลและสกุลเงินที่ตรวจจากหน้า Pricing ในวันประเมิน รวม Cached Input, Tool Fees, ภาษีและส่วนต่างอัตราแลกเปลี่ยนเมื่อเกี่ยวข้อง แล้วใช้ Billing/Usage จริงตรวจทานหลังเปิด Pilot ห้ามนำ 8,000 บาทไปเสนอเป็นค่าบริการจริงหรือรับประกันค่าใช้จ่ายของ SME ทุกราย
RAG และ Vector Database เพิ่มต้นทุนอะไรบ้าง
ถ้าต้องค้นคู่มือหรือเอกสารบริษัท อาจมีค่าแปลงเอกสารเป็นข้อความ การแบ่ง Chunk, Embedding, Storage/Index, Retrieval Query, Re-index เมื่อไฟล์เปลี่ยน และเวลาเจ้าของเนื้อหาตรวจความถูกต้อง
ไม่จำเป็นต้องมี Vector Database ทุกครั้ง หาก Bot ตอบคำถามจากข้อมูลสาธารณะไม่กี่ข้อ อาจใช้ FAQ Lookup ที่เรียบง่ายกว่า การเลือก RAG ควรดูว่าฐานความรู้มีขนาด/ความเปลี่ยนแปลงเพียงใดและต้องอ้างเอกสารหรือไม่
ตัวอย่างเชิงออกแบบ: บริษัทมีคู่มือหลายเวอร์ชัน ถ้า Index ยังเก็บฉบับเก่า Bot อาจตอบผิดแม้จ่ายค่าค้นไปแล้ว ดังนั้นค่าใช้จ่ายที่แท้จริงต้องรวมเวลาจัดการเอกสารและสิทธิ์ ไม่ใช่แค่ค่าค้น Vector
อ่าน RAG Chatbot และ Vector Database ประกอบ และดูแนวทาง AWS Generative AI Cost Modelling ที่แยกต้นทุน Model, Query Volume, Infrastructure และ Knowledge Store
ใช้ n8n Workflow หรือ API Integration มีต้นทุนอย่างไร
ต้นทุน Automation อาจคิดตามจำนวน Workflow Executions, Task/Operation, Server/Database, Queue/Storage และงานดูแล Credential แทนที่จะคิดต่อข้อความอย่างเดียว
เอกสาร n8n Chat Trigger ระบุว่าในโฟลว์ Chat Trigger หนึ่งข้อความที่เข้ามาทำให้ Workflow ทำงานหนึ่ง Execution ดังนั้นตัวอย่างบทสนทนาที่ผู้ใช้ส่งสิบข้อความจะใช้สิบ Executions ตามเงื่อนไขนี้ แต่ต้องตรวจ Plan/Node/Version และจำนวน Executions อื่นที่ Workflow เรียกด้วย
หากมี CRM/Order API ที่มีผลต่อข้อมูลจริง ให้รวมค่าออกแบบ Identity, Authorization, Idempotency, Retry, Audit และการทดสอบปลายทางเมื่อระบบล่ม ไม่คิดว่าเชื่อม HTTP Request Node แล้วต้นทุนหมดไป อ่าน n8n Chatbot Workflow กับ Chatbot CRM Integration เพื่อเห็นส่วนเพิ่มนี้
ค่า Hosting, Logs และความปลอดภัยมักถูกมองข้าม
แม้โมเดลอยู่บน Cloud ผู้ให้บริการ แอปขององค์กรยังอาจต้องมี Backend, CDN, Database, Cache, Secret Store, Queue, Monitoring, Alert และวิธี Recovery เมื่อบริการปลายทางไม่พร้อม
Logs อาจมีข้อมูลลูกค้า ต้องคุมการเข้าถึง Redaction และ Retention ซึ่งมีทั้งต้นทุนระบบและต้นทุนดูแล การเก็บข้อความทุกประโยคตลอดไปเพื่อหวังเก็บ Analytics อาจทำให้ค่า Storage และความเสี่ยงเพิ่มขึ้นโดยไม่จำเป็น
ระบบที่มีหลาย Tenant ต้องแยกสิทธิ์ข้อมูลอย่างเข้มงวด ค่าเชื่อมระบบและทดสอบสิทธิ์จึงอาจมากกว่าค่า Token ในบางโครงการ และไม่ควรถูกตัดออกเพื่อให้ตัวเลขงบดูต่ำ
Hidden Costs: คนดูแลเนื้อหาและ Human Handoff
AI Chatbot ไม่ใช่ระบบที่ติดตั้งแล้วไม่มีคนดูแล หากเวลาเปิดบริการ นโยบายคืนสินค้า หรือสินค้าเปลี่ยน ต้องมีเจ้าของข้อมูลแก้เนื้อหา/Index ส่วนกรณี Bot ตอบไม่ได้ต้องส่ง Ticket ที่มีคนรับผิดชอบจริง
ค่าแรงเจ้าหน้าที่รับช่วง การตรวจเคสที่ Bot ตอบผิด การจัดการ Complaint และการอัปเดตชุดคำถามทดสอบควรอยู่ในงบต่อเนื่องด้วย การนับว่าทุกเคสที่ไม่ส่งคนคือประหยัดเงินอาจผิด เพราะบางเคสลูกค้าออกจากแชตโดยไม่ได้แก้ปัญหา
ดู Human Handoff และ Chatbot KPI เพื่อกำหนดผลสำเร็จและ Cost per Resolved Case ให้ตรงกับงานบริการจริง
จะลดค่าใช้จ่ายโดยไม่ทำให้คุณภาพตกอย่างไร
แนวทาง AWS เรื่อง Cost Optimization ชี้แนวคิดให้คุม Context, เลือกโมเดลเหมาะกับงานและลดการเรียก Tool ซ้ำโดยไม่จำเป็น
ตัวอย่างทางเลือกที่ควรทดลองและ ทดสอบคุณภาพหลังปรับทุกครั้ง ได้แก่ ตอบ FAQ ตรงโดยไม่ต้องใช้ LLM, เลือก Retrieval เฉพาะเอกสารที่เกี่ยวข้อง, เก็บ Cache เฉพาะข้อมูลที่ไม่เสี่ยงเก่าและมีสิทธิ์ถูกต้อง, ลดข้อความ Prompt ที่ซ้ำไม่จำเป็น และตั้งเพดาน Retry/Timeout
อย่าลดงบโดยปิด Authorization, เลิกเก็บเหตุการณ์ที่ต้อง Audit หรือใช้โมเดลที่คุณภาพไม่เพียงพอสำหรับงานเสี่ยงสูง การประหยัดที่ทำให้เกิดข้อมูลรั่วหรือคำตอบผิดอาจสร้างต้นทุนมากกว่า Token ที่ลดได้
คิด TCO และ ROI จากข้อมูลจริงอย่างไร
TCO (Total Cost of Ownership) คือผลรวมต้นทุนตลอดช่วงที่กำหนด ไม่ใช่เฉพาะบิลโมเดลหนึ่งเดือน
TCO(period) =
  setup_cost
+ sum(monthly_model + retrieval + tool + hosting + support + staff)
+ maintenance_and_security_review
ส่วน ROI ต้องมีกติกาว่าจะนับประโยชน์อย่างไร เช่น เวลาของเจ้าหน้าที่ที่ลดลงจริงหลังควบคุมความต่างปริมาณงาน หรือยอดขายที่มีหลักฐาน Attribution ชัด ห้ามใช้ข้อความที่ Bot ส่งสำเร็จเป็นการรับรองว่าประหยัดชั่วโมงพนักงานหรือขายได้เพิ่ม
หากไม่มี Baseline ให้รายงานเพียง Cost per Conversation, Cost per Verified Resolution และปริมาณงานจริงก่อน สร้างสถานการณ์จำลองเพื่อคุยเรื่องงบได้ แต่ต้องแยกจากผลที่เกิดขึ้นจริงอย่างชัดเจน
คำถามที่พบบ่อย
ค่า API ของ ChatGPT กับ Chatbot ใช้อันเดียวกันไหม
ต้องแยกแผนการใช้งานแอป ChatGPT จากการคิดค่าบริการ API ของผู้ให้บริการที่ใช้สร้างระบบจริง ตรวจสัญญาและหน้า Pricing ของบริการนั้นก่อนคำนวณ
ทำไมค่าต่อข้อความคำนวณจากค่าต่อ Token ตรง ๆ ไม่ได้เสมอ
เพราะหนึ่งข้อความอาจมีหลาย Model Calls, Retrieval, Tool Calls, Retry และข้อมูลประวัติสนทนาที่ส่งซ้ำ หรือบางข้อความใช้ FAQ ไม่เรียกโมเดลเลย ต้องใช้ Usage Trace จริง
ควรตั้งงบสูงสุดเท่าไร
ขึ้นกับโครงการและความเสี่ยง กำหนด Budget Alert, Hard Stop/Graceful Fallback ตามที่ระบบรองรับ และใช้ Scenario จากปริมาณข้อความของกิจการแทนการอ้างตัวเลขมาตรฐานที่ไม่มีหลักฐาน
แหล่งอ้างอิง
- OpenAI API — Pricing
- AWS — Architecting generative AI applications for production
- AWS — Cost optimization
- n8n Docs — Chat Trigger
ตรวจแหล่งอ้างอิง: 2 พฤศจิกายน 2026; สูตรเป็นแบบจำลองงบ ไม่ใช่ราคาเสนอขายหรือการรับรองราคาผู้ให้บริการที่อาจเปลี่ยนได้
เลือกหัวข้อที่เกี่ยวข้องเพื่อทำความเข้าใจแนวคิดและข้อจำกัดก่อนนำไปใช้จริง
ดูบทความหมวดเทคโนโลยี ↗